Aktualisiert am:
CV Parser: Wenn der Lebenslauf als Daten für dich arbeitet
Neuigkeiten
Iwo Paliszewski
CV Parser: Wenn der Lebenslauf als Daten zu arbeiten beginnt
Für viele Recruiting-Teams wird das CV immer noch hauptsächlich als reines Dokument betrachtet.
Etwas, das man öffnen, lesen, bewerten, herunterladen, weiterleiten, vergleichen und archivieren kann. Oft ist es der Startpunkt des Recruiting-Prozesses, aber dort endet seine Rolle meistens auch schon: Es bleibt einfach eine Datei, die an das Kandidatenprofil angehängt ist.
Das Problem ist, dass Recruiting-Teams nicht nur Dokumente brauchen. Sie brauchen nutzbare Informationen.
Sie müssen wissen, welche Skills der Kandidat hat, wo er gearbeitet hat, welche Unternehmen in seiner Historie auftauchen, welche Positionen er innehatte, welche Sprachen er spricht und wo er sich befindet. Und vor allem – wie man all das nahtlos durchsuchen, filtern, verknüpfen und in Zukunft nutzen kann.
Genau deshalb sehen wir das Parsen von CVs als etwas viel Wichtigeres an als nur ein „schnelleres Hochladen des Lebenslaufs“.
Ein guter CV Parser sollte nicht nur dazu dienen, Zeit beim manuellen Abtippen von Daten zu sparen. Er sollte dabei helfen, ein statisches Dokument in strukturierte Recruiting-Daten zu verwandeln. Und wenn das CV zu einem Datensatz wird, fängt es an, sich für den Recruiter richtig bezahlt zu machen.
Ein CV ist viel mehr als nur Kontaktdaten
Wenn wir an das Parsen von CVs denken, fallen uns meist die absoluten Basics ein: Name, E-Mail-Adresse, Telefonnummer, Position, Ausbildung und Berufserfahrung.
Natürlich ist das sehr nützlich. Niemand möchte Informationen manuell aus einem PDF kopieren, wenn das System das automatisch erledigen kann. Doch im Recruiting geht der wahre Wert eines CVs weit über bloße Kontaktdaten hinaus.
Ein CV ist eine vollständige berufliche Historie. Darin verbergen sich Unternehmen, Branchen, Karrierewege, Skills, Seniority-Level, Technologien, Fremdsprachen, Standorte und jede Menge impliziter Kontext, der in Zukunft entscheidend sein kann.
Ein Beispiel: Wenn ein Kandidat für drei verschiedene Softwarehäuser gearbeitet hat, sendet uns das ein klares Signal. Wenn er von einer Recruiting-Agentur in die interne HR gewechselt ist – auch das ist wichtig. Es spielt auch eine Rolle, ob er Jahre im Finanzwesen, im Gesundheitswesen, in der Logistik oder in der Produktion verbracht hat. Sein Standort ist entscheidend, besonders wenn wir für hybride, lokale, komplett remote oder relocation-pflichtige Rollen rekrutieren.
Ein CV ist nicht nur ein Dokument. Es ist eine Landkarte beruflicher Erfahrungen, Beziehungen und des Marktkontexts.
Die Herausforderung besteht darin, dass diese Landkarte meist in unstrukturiertem Text verborgen ist. Solange das System sie nicht herausextrahieren, strukturieren und mit dem Rest der Datenbank verknüpfen kann, bleibt der Großteil dieses Wertes in einer Datei gefangen.
Manuelle Dateneingabe erzeugt Reibung und Inkonsistenzen
Recruiter sind in der Regel hervorragend darin, ein CV zu verstehen. Das Problem ist nicht die menschliche Interpretation. Das Problem ist die Wiederholbarkeit.
Wenn ein Recruiter manuell ein Kandidatenprofil anlegen, Daten kopieren, den Werdegang hinzufügen, Skills heraussuchen, Firmennamen eintragen, den Standort hinzufügen und das Ganze entsprechend strukturieren muss – wird der Prozess langsamer und viel inkonsistenter.
Ein Recruiter schreibt „JavaScript“, ein anderer „JS“. Jemand fügt „Englisch“ als Sprache hinzu, während ein anderer es weglässt, weil es für die jeweilige Rolle nicht gefordert war. Ein Recruiter trägt Berlin als Standort ein, der andere lässt das Feld leer. Einer legt ein vollständiges Firmenprofil für den vorherigen Arbeitgeber an, ein anderer hinterlässt den Namen nur als Textzeile in einer Notiz.
Einzeln betrachtet mögen diese Entscheidungen banal erscheinen. Aber mit der Zeit bestimmen genau sie die Qualität der Datenbank.
Und die Qualität der Datenbank ist von fundamentaler Bedeutung. Sie beeinflusst die Suche, das Reporting, den Aufbau von Talent Pools, Direct Search, das Matchen von Kandidaten und die Möglichkeit, sie wiederzuverwenden. Wenn Informationen nicht gleich zu Beginn gut strukturiert werden, verliert das System sehr schnell an Vertrauen.
Deshalb ist das Parsen nicht nur eine Frage der Geschwindigkeit. Es ist eine Frage der Datenkonsistenz.
Vom CV-File zum vollwertigen Kandidatenprofil
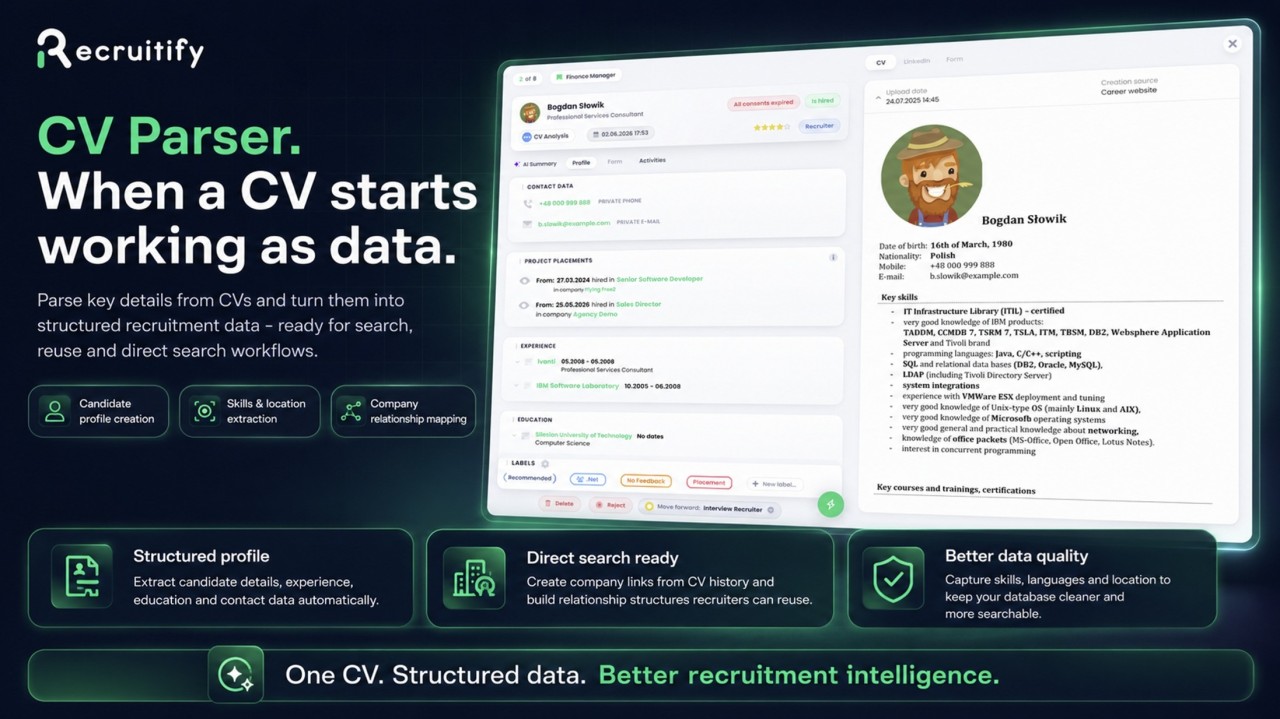
Das Hauptziel des CV Parsers in Recruitify ist einfach: Recruiter dabei zu unterstützen, Kandidatenprofile schneller und mit minimalem manuellem Aufwand zu erstellen.
Nach dem Hochladen des Lebenslaufs extrahiert das System die wichtigsten Informationen und baut darauf ein fertiges Profil auf. Dies umfasst Stammdaten, Erfahrung, Ausbildung, Skills, Sprachen, Standort und alle anderen relevanten Details, die sofort im Recruiting-Prozess genutzt werden können.
Das ist enorm wichtig, da die ersten Minuten der Arbeit mit einem Kandidaten oft darüber entscheiden, ob die Datenbank in Zukunft nützlich sein wird.
Wenn das Profil unvollständig oder schwer zu finden ist, weil wichtige Skills oder der Standort fehlen, wird der Recruiter zwar den aktuellen Prozess durchziehen, aber der Kandidat verliert für zukünftige Projekte an Wert. Ein gut geparstes Profil erleichtert das Finden, Vergleichen, Qualifizieren und die erneute Ansprache bei der nächsten Suche.
Das CV ist nicht mehr nur ein Anhang. Es wird zu einem integralen Bestandteil des Recruiting-Systems.
Standortdaten helfen, die Datenbank zu strukturieren
Der Standort ist eines dieser Details, die banal klingen, im Recruiting aber einen riesigen Unterschied machen können.
Viele Suchanfragen werden immer noch von der Geografie diktiert. Selbst im Zeitalter von Remote Work sind viele Rollen hybrid, regional, an einen bestimmten Kunden, ein Land, ein Büro oder eine Zeitzone gebunden. Aus rechtlichen, gehaltlichen oder sprachlichen Gründen – der Standort ist nach wie vor extrem wichtig.
Wenn der Standort des Kandidaten nur im Text des CVs verborgen ist, können Recruiter ihn bei zukünftigen Suchen leicht übersehen. Wenn er jedoch im Profil strukturiert hinterlegt ist, wird das Filtern der Datenbank kinderleicht.
Genau deshalb ist die Extraktion des Standorts so wichtig. Ein Parser, der hilft, den richtigen Wohnort dem Profil zuzuordnen, sorgt für eine bessere Organisation der gesamten Datenbank. Er macht sie sauberer und nützlicher für zukünftige Rollen. Zudem vermeidet er das unnötige manuelle Durchsuchen von Dutzenden Profilen, wenn das Team dringend einen Kandidaten aus einer bestimmten Region benötigt.
Und auch hier gilt: Es geht nicht darum, ein weiteres Kästchen im System auszufüllen. Es geht darum, dass die Daten des Kandidaten voll einsatzbereit sind.
Aufbau einer Unternehmensdatenbank auf Basis von Kandidaten-CVs
Ein Bereich, der uns bei Recruitify besonders am Herzen lag, sind die Beziehungen zwischen Kandidaten und Unternehmen.
In vielen Recruiting-Systemen existieren Unternehmen nur dann, wenn jemand aus dem Team sie manuell als Kunden oder Arbeitgeber anlegt. Dabei stecken CVs von Kandidaten voller Informationen über Unternehmen. Der Werdegang zeigt, wo der Kandidat gearbeitet hat, welche Firmen auf dem jeweiligen Talentmarkt eine Rolle spielen und wie sich Menschen zwischen Arbeitgebern bewegen.
Deshalb kann unser Parser auch Unternehmensdaten direkt aus den Lebensläufen der Kandidaten erstellen.
Wenn das CV des Kandidaten frühere Arbeitgeber auflistet, extrahiert das System automatisch deren Namen und hilft, sie in der Datenbank anzulegen oder zu verknüpfen. Der Kandidat wird dauerhaft mit diesen Organisationen als aktueller oder ehemaliger Mitarbeiter verbunden.
Das mag wie ein kleines technisches Detail klingen, aber für Recruiting-Teams – insbesondere Agenturen und Headhunter – ist diese Funktion Gold wert. Denn Recruiting bedeutet nicht nur, einzelne Kandidaten zu analysieren. Es bedeutet, den gesamten Markt tiefgehend zu verstehen.
Aufbau von Beziehungsstrukturen für Direct Search
Direct Search basiert stark auf Kontext. Recruiter wollen nicht nur wissen, wer der Kandidat ist, sondern auch, wo er gearbeitet hat, welche Firmen bestimmte Talent-Typen „hervorbringen“, welche Organisationen in einem bestimmten Sektor relevant sind und wie Kandidaten untereinander vernetzt sind.
Wenn das System Unternehmensstrukturen aus den CVs erstellt und Kandidaten sofort damit verknüpft, wird die Datenbank zu mehr als nur einer Liste von Profilen. Sie verwandelt sich in eine Landkarte von Marktbeziehungen.
Das ist ein unschätzbarer Vorteil, wenn Recruiter an ähnlichen Rollen arbeiten, Wettbewerber analysieren, Marktanalysen erstellen oder nach Talenten mit Erfahrung in einem ganz bestimmten Geschäftsumfeld suchen.
Beispiel: Ein Recruiter möchte Personen finden, die in bestimmten Technologie-, Consulting-, Medizin- oder Produktionsunternehmen gearbeitet haben. Wenn diese Information nur in einem PDF-File liegt, ist sie praktisch nutzlos. Wenn sie im System gemappt ist, lässt sie sich im Handumdrehen finden.
Und das verändert den Wert der gesamten Datenbank grundlegend.
Skill-Extraktion verwandelt Erfahrung in suchbare Signale
Fähigkeiten (Skills) gehören zu den wichtigsten Bestandteilen von Recruiting-Daten, sind aber gleichzeitig der Bereich, den man durch schlechtes Tagging am leichtesten ruinieren kann.
Kandidaten beschreiben ihre Kompetenzen auf unterschiedlichste Weise. Die Dokumentenformate variieren. Die einen haben hervorragend strukturierte Listen von Technologien, die anderen verstecken sie in langen Stellenbeschreibungen. Manche nutzen Abkürzungen, andere die vollen Bezeichnungen.
Der Parser hilft, diese Skills herauszufiltern und als nützliche Tags im System zu vereinheitlichen.
Dies ist entscheidend für die erweiterte Suche, den Aufbau von Talent Pools, das Reporting und zukünftige Projekte. Wenn Skills richtig erfasst werden, können Recruiter schnell auf die Datenbank zugreifen und passende Personen finden, anstatt jedes Mal wieder bei null mit dem externen Sourcing anzufangen.
Aber das ist nicht einfach nur das Hinzufügen von mehr Keywords. Es ist das Erstellen von strukturierten Signalen.
Wenn wir Kompetenzen, Erfahrung, Unternehmen, Sprachen, Standorte und Historie miteinander verknüpfen, entfaltet die Datenbank eine enorme Power. Recruiter können Suchen mit größerer Sicherheit durchführen, Kandidaten effektiver segmentieren und Talente identifizieren, die sonst für immer in den Tiefen alter Dateien verschwunden wären.
Bessere Daten bedeuten bessere Wiederverwendung (Reuse)
Eine Recruiting-Datenbank ist erst dann wertvoll, wenn man sie wiederverwenden kann. Nicht nur für ein einzelnes, aktuelles Projekt, sondern für zukünftige Vakanzen, bei verschiedenen Kunden, zur Pflege von Talent Pools und zum Aufbau langfristiger Beziehungen zu Kandidaten.
Genau in solchen Momenten erweisen sich strukturierte Daten aus dem CV als kritisch. Wenn der Parser Details aus dem Dokument extrahiert, kann der Recruiter auf dieser Basis dynamische Talent Pools erstellen, erweiterte Suchen starten und Top-Profile aus früheren Prozessen identifizieren.
Ohne strukturierte Daten dümpelt der Kandidat zwar im System herum, aber ihn im richtigen Moment an die Oberfläche zu holen, ist extrem mühsam. Und ein Kandidat, den man im entscheidenden Moment nicht finden kann, ist genau so viel wert wie ein Kandidat, den man gar nicht erst in der Datenbank hat.
Das ist einer der Gründe, warum wir der Meinung sind, dass Parsen in erster Linie als Tool zur Sicherung der Datenqualität verstanden werden sollte, und erst in zweiter Linie als Arbeitserleichterung.
Der Parser sichert die Zukunft deiner Datenbank
Die Qualität jeder Recruiting-Datenbank hängt davon aus, wie die Daten in sie hineinkommen.
Wenn dieser Prozess manuell, inkonsistent oder oberflächlich abläuft, wird das System langsam unbrauchbar. Mit der Zeit verlieren Recruiter schlichtweg das Vertrauen darin. Sie kehren zu LinkedIn zurück und investieren in neue Anzeigen, weil die interne Suche unberechenbar wirkt.
Ein guter Parser hilft, das direkt von Anfang an zu verhindern.
Er schafft ein starkes Fundament für das Kandidatenprofil, Firmenbeziehungen, die Standortsuche, Skills, zukünftige Automatisierungen und die Wiederverwendbarkeit der Datenbank. Er hilft dabei, die Nutzbarkeit des Systems nicht nur heute, sondern auch in vielen Monaten und Jahren aufrechtzuerhalten.
Natürlich bedeutet das nicht, dass jedes Profil makellos sein wird. CV-Formate sind unkonventionell. Informationen sind nicht immer vollständig. Die menschliche Überprüfung spielt weiterhin eine wichtige Rolle. Aber das Ziel ist ja nicht, den Recruiter aus dem Prozess auszuschließen. Das Ziel ist es, unnötige, repetitive Routinearbeit zu eliminieren und einen viel besseren Ausgangspunkt zu schaffen.
CV-Parsing ist nicht nur lästige Administration
Es ist sehr leicht, die Einführung eines CV Parsers abzutun, weil es nach rein operativem Handwerk klingt. CV hochladen. Daten extrahieren. Profil erstellen.
In Wirklichkeit berührt dieser Prozess etwas viel Größeres: die Qualität des gesamten Recruiting-Systems.
Wenn die Kandidatendaten schlecht sind, wird die Suche mühsam.
Wenn die Verknüpfungen zu Unternehmen fehlen, hinkt das Markt-Mapping hinterher.
Wenn die Skills nicht vereinheitlicht sind, scheitert das Matchen von Kandidaten.
Wenn der Standort fehlt, werden Filter nutzlos.
Wenn Profile lückenhaft sind, verlieren Talent Pools an Wert.
Wenn die Datenbank kein Vertrauen erweckt – muss das Team wieder von vorn anfangen.
Genau deshalb ist der CV Parser in Recruitify nicht nur ein Tool, um beim Hinzufügen einer Bewerbung ein paar Minuten zu sparen. Er ist der Mechanismus, der dafür sorgt, dass wertvolle Informationen aus dem Lebenslauf nicht in einem toten Dokument stecken bleiben, sondern voll strukturiert, suchbar und mit dem gesamten Ökosystem verknüpft werden.
Warum wir es genau so konzipiert haben
Wir haben unseren CV Parser so gebaut, weil wir wissen, dass Recruiting-Teams bereits über viel mehr Informationen verfügen, als ihnen bewusst ist. Das Problem ist nur, dass der Großteil davon in Dateien, Notizen und verstreuten Postfächern schlummert.
Ein CV sollte kein toter Anhang im System sein. Es sollte aktiv das Kandidatenprofil mitgestalten, die Datenbank anreichern, den geschäftlichen Firmenkontext aufbauen, Direct Search unterstützen, Kompetenzen sowie Standorte ordnen und Recruitern die Arbeit in Zukunft spürbar erleichtern.
Denn Recruiting-Daten haben nur dann einen Wert, wenn man sie jederzeit nutzen kann. Und in dem Moment, in dem das CV als Daten zu arbeiten beginnt, wird der gesamte Recruiting-Prozess zu einem unglaublich eng verzahnten, integrierten Ganzen.
Das war die Vision bei der Entwicklung des CV Parsers in Recruitify: Es geht nicht nur darum, schneller eine neue Profilkarte anzulegen. Es geht darum, intelligente Recruiting-Analysen vom ersten Klick an aufzubauen.
Updates und News
Bleib immer up to date mit den neuesten Innovationen, Features und Tipps rund um Recruitify!
Indem Du Deine E-Mail-Adresse im Anmeldeformular für den Newsletter einträgst, willigst Du in deren Verarbeitung zum Zwecke des Versands von Marketinginformationen über die Produkte und Dienstleistungen des Administrators ein. Der Administrator Deiner zu diesem Zweck verarbeiteten personenbezogenen Daten ist Recruitify Sp. z o.o. mit Sitz in Warschau (KRS 0000709889). Weitere Informationen über die Grundsätze der Verarbeitung personenbezogener Daten und die Rechte der betroffenen Personen findest Du im Dokument Datenschutzerklärung.

Aktualisiert am:
CV Parser: Wenn der Lebenslauf als Daten für dich arbeitet
Neuigkeiten
Iwo Paliszewski
CV Parser: Wenn der Lebenslauf als Daten zu arbeiten beginnt
Für viele Recruiting-Teams wird das CV immer noch hauptsächlich als reines Dokument betrachtet.
Etwas, das man öffnen, lesen, bewerten, herunterladen, weiterleiten, vergleichen und archivieren kann. Oft ist es der Startpunkt des Recruiting-Prozesses, aber dort endet seine Rolle meistens auch schon: Es bleibt einfach eine Datei, die an das Kandidatenprofil angehängt ist.
Das Problem ist, dass Recruiting-Teams nicht nur Dokumente brauchen. Sie brauchen nutzbare Informationen.
Sie müssen wissen, welche Skills der Kandidat hat, wo er gearbeitet hat, welche Unternehmen in seiner Historie auftauchen, welche Positionen er innehatte, welche Sprachen er spricht und wo er sich befindet. Und vor allem – wie man all das nahtlos durchsuchen, filtern, verknüpfen und in Zukunft nutzen kann.
Genau deshalb sehen wir das Parsen von CVs als etwas viel Wichtigeres an als nur ein „schnelleres Hochladen des Lebenslaufs“.
Ein guter CV Parser sollte nicht nur dazu dienen, Zeit beim manuellen Abtippen von Daten zu sparen. Er sollte dabei helfen, ein statisches Dokument in strukturierte Recruiting-Daten zu verwandeln. Und wenn das CV zu einem Datensatz wird, fängt es an, sich für den Recruiter richtig bezahlt zu machen.
Ein CV ist viel mehr als nur Kontaktdaten
Wenn wir an das Parsen von CVs denken, fallen uns meist die absoluten Basics ein: Name, E-Mail-Adresse, Telefonnummer, Position, Ausbildung und Berufserfahrung.
Natürlich ist das sehr nützlich. Niemand möchte Informationen manuell aus einem PDF kopieren, wenn das System das automatisch erledigen kann. Doch im Recruiting geht der wahre Wert eines CVs weit über bloße Kontaktdaten hinaus.
Ein CV ist eine vollständige berufliche Historie. Darin verbergen sich Unternehmen, Branchen, Karrierewege, Skills, Seniority-Level, Technologien, Fremdsprachen, Standorte und jede Menge impliziter Kontext, der in Zukunft entscheidend sein kann.
Ein Beispiel: Wenn ein Kandidat für drei verschiedene Softwarehäuser gearbeitet hat, sendet uns das ein klares Signal. Wenn er von einer Recruiting-Agentur in die interne HR gewechselt ist – auch das ist wichtig. Es spielt auch eine Rolle, ob er Jahre im Finanzwesen, im Gesundheitswesen, in der Logistik oder in der Produktion verbracht hat. Sein Standort ist entscheidend, besonders wenn wir für hybride, lokale, komplett remote oder relocation-pflichtige Rollen rekrutieren.
Ein CV ist nicht nur ein Dokument. Es ist eine Landkarte beruflicher Erfahrungen, Beziehungen und des Marktkontexts.
Die Herausforderung besteht darin, dass diese Landkarte meist in unstrukturiertem Text verborgen ist. Solange das System sie nicht herausextrahieren, strukturieren und mit dem Rest der Datenbank verknüpfen kann, bleibt der Großteil dieses Wertes in einer Datei gefangen.
Manuelle Dateneingabe erzeugt Reibung und Inkonsistenzen
Recruiter sind in der Regel hervorragend darin, ein CV zu verstehen. Das Problem ist nicht die menschliche Interpretation. Das Problem ist die Wiederholbarkeit.
Wenn ein Recruiter manuell ein Kandidatenprofil anlegen, Daten kopieren, den Werdegang hinzufügen, Skills heraussuchen, Firmennamen eintragen, den Standort hinzufügen und das Ganze entsprechend strukturieren muss – wird der Prozess langsamer und viel inkonsistenter.
Ein Recruiter schreibt „JavaScript“, ein anderer „JS“. Jemand fügt „Englisch“ als Sprache hinzu, während ein anderer es weglässt, weil es für die jeweilige Rolle nicht gefordert war. Ein Recruiter trägt Berlin als Standort ein, der andere lässt das Feld leer. Einer legt ein vollständiges Firmenprofil für den vorherigen Arbeitgeber an, ein anderer hinterlässt den Namen nur als Textzeile in einer Notiz.
Einzeln betrachtet mögen diese Entscheidungen banal erscheinen. Aber mit der Zeit bestimmen genau sie die Qualität der Datenbank.
Und die Qualität der Datenbank ist von fundamentaler Bedeutung. Sie beeinflusst die Suche, das Reporting, den Aufbau von Talent Pools, Direct Search, das Matchen von Kandidaten und die Möglichkeit, sie wiederzuverwenden. Wenn Informationen nicht gleich zu Beginn gut strukturiert werden, verliert das System sehr schnell an Vertrauen.
Deshalb ist das Parsen nicht nur eine Frage der Geschwindigkeit. Es ist eine Frage der Datenkonsistenz.
Vom CV-File zum vollwertigen Kandidatenprofil
Das Hauptziel des CV Parsers in Recruitify ist einfach: Recruiter dabei zu unterstützen, Kandidatenprofile schneller und mit minimalem manuellem Aufwand zu erstellen.
Nach dem Hochladen des Lebenslaufs extrahiert das System die wichtigsten Informationen und baut darauf ein fertiges Profil auf. Dies umfasst Stammdaten, Erfahrung, Ausbildung, Skills, Sprachen, Standort und alle anderen relevanten Details, die sofort im Recruiting-Prozess genutzt werden können.
Das ist enorm wichtig, da die ersten Minuten der Arbeit mit einem Kandidaten oft darüber entscheiden, ob die Datenbank in Zukunft nützlich sein wird.
Wenn das Profil unvollständig oder schwer zu finden ist, weil wichtige Skills oder der Standort fehlen, wird der Recruiter zwar den aktuellen Prozess durchziehen, aber der Kandidat verliert für zukünftige Projekte an Wert. Ein gut geparstes Profil erleichtert das Finden, Vergleichen, Qualifizieren und die erneute Ansprache bei der nächsten Suche.
Das CV ist nicht mehr nur ein Anhang. Es wird zu einem integralen Bestandteil des Recruiting-Systems.
Standortdaten helfen, die Datenbank zu strukturieren
Der Standort ist eines dieser Details, die banal klingen, im Recruiting aber einen riesigen Unterschied machen können.
Viele Suchanfragen werden immer noch von der Geografie diktiert. Selbst im Zeitalter von Remote Work sind viele Rollen hybrid, regional, an einen bestimmten Kunden, ein Land, ein Büro oder eine Zeitzone gebunden. Aus rechtlichen, gehaltlichen oder sprachlichen Gründen – der Standort ist nach wie vor extrem wichtig.
Wenn der Standort des Kandidaten nur im Text des CVs verborgen ist, können Recruiter ihn bei zukünftigen Suchen leicht übersehen. Wenn er jedoch im Profil strukturiert hinterlegt ist, wird das Filtern der Datenbank kinderleicht.
Genau deshalb ist die Extraktion des Standorts so wichtig. Ein Parser, der hilft, den richtigen Wohnort dem Profil zuzuordnen, sorgt für eine bessere Organisation der gesamten Datenbank. Er macht sie sauberer und nützlicher für zukünftige Rollen. Zudem vermeidet er das unnötige manuelle Durchsuchen von Dutzenden Profilen, wenn das Team dringend einen Kandidaten aus einer bestimmten Region benötigt.
Und auch hier gilt: Es geht nicht darum, ein weiteres Kästchen im System auszufüllen. Es geht darum, dass die Daten des Kandidaten voll einsatzbereit sind.
Aufbau einer Unternehmensdatenbank auf Basis von Kandidaten-CVs
Ein Bereich, der uns bei Recruitify besonders am Herzen lag, sind die Beziehungen zwischen Kandidaten und Unternehmen.
In vielen Recruiting-Systemen existieren Unternehmen nur dann, wenn jemand aus dem Team sie manuell als Kunden oder Arbeitgeber anlegt. Dabei stecken CVs von Kandidaten voller Informationen über Unternehmen. Der Werdegang zeigt, wo der Kandidat gearbeitet hat, welche Firmen auf dem jeweiligen Talentmarkt eine Rolle spielen und wie sich Menschen zwischen Arbeitgebern bewegen.
Deshalb kann unser Parser auch Unternehmensdaten direkt aus den Lebensläufen der Kandidaten erstellen.
Wenn das CV des Kandidaten frühere Arbeitgeber auflistet, extrahiert das System automatisch deren Namen und hilft, sie in der Datenbank anzulegen oder zu verknüpfen. Der Kandidat wird dauerhaft mit diesen Organisationen als aktueller oder ehemaliger Mitarbeiter verbunden.
Das mag wie ein kleines technisches Detail klingen, aber für Recruiting-Teams – insbesondere Agenturen und Headhunter – ist diese Funktion Gold wert. Denn Recruiting bedeutet nicht nur, einzelne Kandidaten zu analysieren. Es bedeutet, den gesamten Markt tiefgehend zu verstehen.
Aufbau von Beziehungsstrukturen für Direct Search
Direct Search basiert stark auf Kontext. Recruiter wollen nicht nur wissen, wer der Kandidat ist, sondern auch, wo er gearbeitet hat, welche Firmen bestimmte Talent-Typen „hervorbringen“, welche Organisationen in einem bestimmten Sektor relevant sind und wie Kandidaten untereinander vernetzt sind.
Wenn das System Unternehmensstrukturen aus den CVs erstellt und Kandidaten sofort damit verknüpft, wird die Datenbank zu mehr als nur einer Liste von Profilen. Sie verwandelt sich in eine Landkarte von Marktbeziehungen.
Das ist ein unschätzbarer Vorteil, wenn Recruiter an ähnlichen Rollen arbeiten, Wettbewerber analysieren, Marktanalysen erstellen oder nach Talenten mit Erfahrung in einem ganz bestimmten Geschäftsumfeld suchen.
Beispiel: Ein Recruiter möchte Personen finden, die in bestimmten Technologie-, Consulting-, Medizin- oder Produktionsunternehmen gearbeitet haben. Wenn diese Information nur in einem PDF-File liegt, ist sie praktisch nutzlos. Wenn sie im System gemappt ist, lässt sie sich im Handumdrehen finden.
Und das verändert den Wert der gesamten Datenbank grundlegend.
Skill-Extraktion verwandelt Erfahrung in suchbare Signale
Fähigkeiten (Skills) gehören zu den wichtigsten Bestandteilen von Recruiting-Daten, sind aber gleichzeitig der Bereich, den man durch schlechtes Tagging am leichtesten ruinieren kann.
Kandidaten beschreiben ihre Kompetenzen auf unterschiedlichste Weise. Die Dokumentenformate variieren. Die einen haben hervorragend strukturierte Listen von Technologien, die anderen verstecken sie in langen Stellenbeschreibungen. Manche nutzen Abkürzungen, andere die vollen Bezeichnungen.
Der Parser hilft, diese Skills herauszufiltern und als nützliche Tags im System zu vereinheitlichen.
Dies ist entscheidend für die erweiterte Suche, den Aufbau von Talent Pools, das Reporting und zukünftige Projekte. Wenn Skills richtig erfasst werden, können Recruiter schnell auf die Datenbank zugreifen und passende Personen finden, anstatt jedes Mal wieder bei null mit dem externen Sourcing anzufangen.
Aber das ist nicht einfach nur das Hinzufügen von mehr Keywords. Es ist das Erstellen von strukturierten Signalen.
Wenn wir Kompetenzen, Erfahrung, Unternehmen, Sprachen, Standorte und Historie miteinander verknüpfen, entfaltet die Datenbank eine enorme Power. Recruiter können Suchen mit größerer Sicherheit durchführen, Kandidaten effektiver segmentieren und Talente identifizieren, die sonst für immer in den Tiefen alter Dateien verschwunden wären.
Bessere Daten bedeuten bessere Wiederverwendung (Reuse)
Eine Recruiting-Datenbank ist erst dann wertvoll, wenn man sie wiederverwenden kann. Nicht nur für ein einzelnes, aktuelles Projekt, sondern für zukünftige Vakanzen, bei verschiedenen Kunden, zur Pflege von Talent Pools und zum Aufbau langfristiger Beziehungen zu Kandidaten.
Genau in solchen Momenten erweisen sich strukturierte Daten aus dem CV als kritisch. Wenn der Parser Details aus dem Dokument extrahiert, kann der Recruiter auf dieser Basis dynamische Talent Pools erstellen, erweiterte Suchen starten und Top-Profile aus früheren Prozessen identifizieren.
Ohne strukturierte Daten dümpelt der Kandidat zwar im System herum, aber ihn im richtigen Moment an die Oberfläche zu holen, ist extrem mühsam. Und ein Kandidat, den man im entscheidenden Moment nicht finden kann, ist genau so viel wert wie ein Kandidat, den man gar nicht erst in der Datenbank hat.
Das ist einer der Gründe, warum wir der Meinung sind, dass Parsen in erster Linie als Tool zur Sicherung der Datenqualität verstanden werden sollte, und erst in zweiter Linie als Arbeitserleichterung.
Der Parser sichert die Zukunft deiner Datenbank
Die Qualität jeder Recruiting-Datenbank hängt davon aus, wie die Daten in sie hineinkommen.
Wenn dieser Prozess manuell, inkonsistent oder oberflächlich abläuft, wird das System langsam unbrauchbar. Mit der Zeit verlieren Recruiter schlichtweg das Vertrauen darin. Sie kehren zu LinkedIn zurück und investieren in neue Anzeigen, weil die interne Suche unberechenbar wirkt.
Ein guter Parser hilft, das direkt von Anfang an zu verhindern.
Er schafft ein starkes Fundament für das Kandidatenprofil, Firmenbeziehungen, die Standortsuche, Skills, zukünftige Automatisierungen und die Wiederverwendbarkeit der Datenbank. Er hilft dabei, die Nutzbarkeit des Systems nicht nur heute, sondern auch in vielen Monaten und Jahren aufrechtzuerhalten.
Natürlich bedeutet das nicht, dass jedes Profil makellos sein wird. CV-Formate sind unkonventionell. Informationen sind nicht immer vollständig. Die menschliche Überprüfung spielt weiterhin eine wichtige Rolle. Aber das Ziel ist ja nicht, den Recruiter aus dem Prozess auszuschließen. Das Ziel ist es, unnötige, repetitive Routinearbeit zu eliminieren und einen viel besseren Ausgangspunkt zu schaffen.
CV-Parsing ist nicht nur lästige Administration
Es ist sehr leicht, die Einführung eines CV Parsers abzutun, weil es nach rein operativem Handwerk klingt. CV hochladen. Daten extrahieren. Profil erstellen.
In Wirklichkeit berührt dieser Prozess etwas viel Größeres: die Qualität des gesamten Recruiting-Systems.
Wenn die Kandidatendaten schlecht sind, wird die Suche mühsam.
Wenn die Verknüpfungen zu Unternehmen fehlen, hinkt das Markt-Mapping hinterher.
Wenn die Skills nicht vereinheitlicht sind, scheitert das Matchen von Kandidaten.
Wenn der Standort fehlt, werden Filter nutzlos.
Wenn Profile lückenhaft sind, verlieren Talent Pools an Wert.
Wenn die Datenbank kein Vertrauen erweckt – muss das Team wieder von vorn anfangen.
Genau deshalb ist der CV Parser in Recruitify nicht nur ein Tool, um beim Hinzufügen einer Bewerbung ein paar Minuten zu sparen. Er ist der Mechanismus, der dafür sorgt, dass wertvolle Informationen aus dem Lebenslauf nicht in einem toten Dokument stecken bleiben, sondern voll strukturiert, suchbar und mit dem gesamten Ökosystem verknüpft werden.
Warum wir es genau so konzipiert haben
Wir haben unseren CV Parser so gebaut, weil wir wissen, dass Recruiting-Teams bereits über viel mehr Informationen verfügen, als ihnen bewusst ist. Das Problem ist nur, dass der Großteil davon in Dateien, Notizen und verstreuten Postfächern schlummert.
Ein CV sollte kein toter Anhang im System sein. Es sollte aktiv das Kandidatenprofil mitgestalten, die Datenbank anreichern, den geschäftlichen Firmenkontext aufbauen, Direct Search unterstützen, Kompetenzen sowie Standorte ordnen und Recruitern die Arbeit in Zukunft spürbar erleichtern.
Denn Recruiting-Daten haben nur dann einen Wert, wenn man sie jederzeit nutzen kann. Und in dem Moment, in dem das CV als Daten zu arbeiten beginnt, wird der gesamte Recruiting-Prozess zu einem unglaublich eng verzahnten, integrierten Ganzen.
Das war die Vision bei der Entwicklung des CV Parsers in Recruitify: Es geht nicht nur darum, schneller eine neue Profilkarte anzulegen. Es geht darum, intelligente Recruiting-Analysen vom ersten Klick an aufzubauen.
Updates und News
Bleib immer up to date mit den neuesten Innovationen, Features und Tipps rund um Recruitify!
Indem Du Deine E-Mail-Adresse im Anmeldeformular für den Newsletter einträgst, willigst Du in deren Verarbeitung zum Zwecke des Versands von Marketinginformationen über die Produkte und Dienstleistungen des Administrators ein. Der Administrator Deiner zu diesem Zweck verarbeiteten personenbezogenen Daten ist Recruitify Sp. z o.o. mit Sitz in Warschau (KRS 0000709889). Weitere Informationen über die Grundsätze der Verarbeitung personenbezogener Daten und die Rechte der betroffenen Personen findest Du im Dokument Datenschutzerklärung.
Aktualisiert am:
CV Parser: Wenn der Lebenslauf als Daten für dich arbeitet
Neuigkeiten
Iwo Paliszewski
CV Parser: Wenn der Lebenslauf als Daten zu arbeiten beginnt
Für viele Recruiting-Teams wird das CV immer noch hauptsächlich als reines Dokument betrachtet.
Etwas, das man öffnen, lesen, bewerten, herunterladen, weiterleiten, vergleichen und archivieren kann. Oft ist es der Startpunkt des Recruiting-Prozesses, aber dort endet seine Rolle meistens auch schon: Es bleibt einfach eine Datei, die an das Kandidatenprofil angehängt ist.
Das Problem ist, dass Recruiting-Teams nicht nur Dokumente brauchen. Sie brauchen nutzbare Informationen.
Sie müssen wissen, welche Skills der Kandidat hat, wo er gearbeitet hat, welche Unternehmen in seiner Historie auftauchen, welche Positionen er innehatte, welche Sprachen er spricht und wo er sich befindet. Und vor allem – wie man all das nahtlos durchsuchen, filtern, verknüpfen und in Zukunft nutzen kann.
Genau deshalb sehen wir das Parsen von CVs als etwas viel Wichtigeres an als nur ein „schnelleres Hochladen des Lebenslaufs“.
Ein guter CV Parser sollte nicht nur dazu dienen, Zeit beim manuellen Abtippen von Daten zu sparen. Er sollte dabei helfen, ein statisches Dokument in strukturierte Recruiting-Daten zu verwandeln. Und wenn das CV zu einem Datensatz wird, fängt es an, sich für den Recruiter richtig bezahlt zu machen.
Ein CV ist viel mehr als nur Kontaktdaten
Wenn wir an das Parsen von CVs denken, fallen uns meist die absoluten Basics ein: Name, E-Mail-Adresse, Telefonnummer, Position, Ausbildung und Berufserfahrung.
Natürlich ist das sehr nützlich. Niemand möchte Informationen manuell aus einem PDF kopieren, wenn das System das automatisch erledigen kann. Doch im Recruiting geht der wahre Wert eines CVs weit über bloße Kontaktdaten hinaus.
Ein CV ist eine vollständige berufliche Historie. Darin verbergen sich Unternehmen, Branchen, Karrierewege, Skills, Seniority-Level, Technologien, Fremdsprachen, Standorte und jede Menge impliziter Kontext, der in Zukunft entscheidend sein kann.
Ein Beispiel: Wenn ein Kandidat für drei verschiedene Softwarehäuser gearbeitet hat, sendet uns das ein klares Signal. Wenn er von einer Recruiting-Agentur in die interne HR gewechselt ist – auch das ist wichtig. Es spielt auch eine Rolle, ob er Jahre im Finanzwesen, im Gesundheitswesen, in der Logistik oder in der Produktion verbracht hat. Sein Standort ist entscheidend, besonders wenn wir für hybride, lokale, komplett remote oder relocation-pflichtige Rollen rekrutieren.
Ein CV ist nicht nur ein Dokument. Es ist eine Landkarte beruflicher Erfahrungen, Beziehungen und des Marktkontexts.
Die Herausforderung besteht darin, dass diese Landkarte meist in unstrukturiertem Text verborgen ist. Solange das System sie nicht herausextrahieren, strukturieren und mit dem Rest der Datenbank verknüpfen kann, bleibt der Großteil dieses Wertes in einer Datei gefangen.
Manuelle Dateneingabe erzeugt Reibung und Inkonsistenzen
Recruiter sind in der Regel hervorragend darin, ein CV zu verstehen. Das Problem ist nicht die menschliche Interpretation. Das Problem ist die Wiederholbarkeit.
Wenn ein Recruiter manuell ein Kandidatenprofil anlegen, Daten kopieren, den Werdegang hinzufügen, Skills heraussuchen, Firmennamen eintragen, den Standort hinzufügen und das Ganze entsprechend strukturieren muss – wird der Prozess langsamer und viel inkonsistenter.
Ein Recruiter schreibt „JavaScript“, ein anderer „JS“. Jemand fügt „Englisch“ als Sprache hinzu, während ein anderer es weglässt, weil es für die jeweilige Rolle nicht gefordert war. Ein Recruiter trägt Berlin als Standort ein, der andere lässt das Feld leer. Einer legt ein vollständiges Firmenprofil für den vorherigen Arbeitgeber an, ein anderer hinterlässt den Namen nur als Textzeile in einer Notiz.
Einzeln betrachtet mögen diese Entscheidungen banal erscheinen. Aber mit der Zeit bestimmen genau sie die Qualität der Datenbank.
Und die Qualität der Datenbank ist von fundamentaler Bedeutung. Sie beeinflusst die Suche, das Reporting, den Aufbau von Talent Pools, Direct Search, das Matchen von Kandidaten und die Möglichkeit, sie wiederzuverwenden. Wenn Informationen nicht gleich zu Beginn gut strukturiert werden, verliert das System sehr schnell an Vertrauen.
Deshalb ist das Parsen nicht nur eine Frage der Geschwindigkeit. Es ist eine Frage der Datenkonsistenz.
Vom CV-File zum vollwertigen Kandidatenprofil
Das Hauptziel des CV Parsers in Recruitify ist einfach: Recruiter dabei zu unterstützen, Kandidatenprofile schneller und mit minimalem manuellem Aufwand zu erstellen.
Nach dem Hochladen des Lebenslaufs extrahiert das System die wichtigsten Informationen und baut darauf ein fertiges Profil auf. Dies umfasst Stammdaten, Erfahrung, Ausbildung, Skills, Sprachen, Standort und alle anderen relevanten Details, die sofort im Recruiting-Prozess genutzt werden können.
Das ist enorm wichtig, da die ersten Minuten der Arbeit mit einem Kandidaten oft darüber entscheiden, ob die Datenbank in Zukunft nützlich sein wird.
Wenn das Profil unvollständig oder schwer zu finden ist, weil wichtige Skills oder der Standort fehlen, wird der Recruiter zwar den aktuellen Prozess durchziehen, aber der Kandidat verliert für zukünftige Projekte an Wert. Ein gut geparstes Profil erleichtert das Finden, Vergleichen, Qualifizieren und die erneute Ansprache bei der nächsten Suche.
Das CV ist nicht mehr nur ein Anhang. Es wird zu einem integralen Bestandteil des Recruiting-Systems.
Standortdaten helfen, die Datenbank zu strukturieren
Der Standort ist eines dieser Details, die banal klingen, im Recruiting aber einen riesigen Unterschied machen können.
Viele Suchanfragen werden immer noch von der Geografie diktiert. Selbst im Zeitalter von Remote Work sind viele Rollen hybrid, regional, an einen bestimmten Kunden, ein Land, ein Büro oder eine Zeitzone gebunden. Aus rechtlichen, gehaltlichen oder sprachlichen Gründen – der Standort ist nach wie vor extrem wichtig.
Wenn der Standort des Kandidaten nur im Text des CVs verborgen ist, können Recruiter ihn bei zukünftigen Suchen leicht übersehen. Wenn er jedoch im Profil strukturiert hinterlegt ist, wird das Filtern der Datenbank kinderleicht.
Genau deshalb ist die Extraktion des Standorts so wichtig. Ein Parser, der hilft, den richtigen Wohnort dem Profil zuzuordnen, sorgt für eine bessere Organisation der gesamten Datenbank. Er macht sie sauberer und nützlicher für zukünftige Rollen. Zudem vermeidet er das unnötige manuelle Durchsuchen von Dutzenden Profilen, wenn das Team dringend einen Kandidaten aus einer bestimmten Region benötigt.
Und auch hier gilt: Es geht nicht darum, ein weiteres Kästchen im System auszufüllen. Es geht darum, dass die Daten des Kandidaten voll einsatzbereit sind.
Aufbau einer Unternehmensdatenbank auf Basis von Kandidaten-CVs
Ein Bereich, der uns bei Recruitify besonders am Herzen lag, sind die Beziehungen zwischen Kandidaten und Unternehmen.
In vielen Recruiting-Systemen existieren Unternehmen nur dann, wenn jemand aus dem Team sie manuell als Kunden oder Arbeitgeber anlegt. Dabei stecken CVs von Kandidaten voller Informationen über Unternehmen. Der Werdegang zeigt, wo der Kandidat gearbeitet hat, welche Firmen auf dem jeweiligen Talentmarkt eine Rolle spielen und wie sich Menschen zwischen Arbeitgebern bewegen.
Deshalb kann unser Parser auch Unternehmensdaten direkt aus den Lebensläufen der Kandidaten erstellen.
Wenn das CV des Kandidaten frühere Arbeitgeber auflistet, extrahiert das System automatisch deren Namen und hilft, sie in der Datenbank anzulegen oder zu verknüpfen. Der Kandidat wird dauerhaft mit diesen Organisationen als aktueller oder ehemaliger Mitarbeiter verbunden.
Das mag wie ein kleines technisches Detail klingen, aber für Recruiting-Teams – insbesondere Agenturen und Headhunter – ist diese Funktion Gold wert. Denn Recruiting bedeutet nicht nur, einzelne Kandidaten zu analysieren. Es bedeutet, den gesamten Markt tiefgehend zu verstehen.
Aufbau von Beziehungsstrukturen für Direct Search
Direct Search basiert stark auf Kontext. Recruiter wollen nicht nur wissen, wer der Kandidat ist, sondern auch, wo er gearbeitet hat, welche Firmen bestimmte Talent-Typen „hervorbringen“, welche Organisationen in einem bestimmten Sektor relevant sind und wie Kandidaten untereinander vernetzt sind.
Wenn das System Unternehmensstrukturen aus den CVs erstellt und Kandidaten sofort damit verknüpft, wird die Datenbank zu mehr als nur einer Liste von Profilen. Sie verwandelt sich in eine Landkarte von Marktbeziehungen.
Das ist ein unschätzbarer Vorteil, wenn Recruiter an ähnlichen Rollen arbeiten, Wettbewerber analysieren, Marktanalysen erstellen oder nach Talenten mit Erfahrung in einem ganz bestimmten Geschäftsumfeld suchen.
Beispiel: Ein Recruiter möchte Personen finden, die in bestimmten Technologie-, Consulting-, Medizin- oder Produktionsunternehmen gearbeitet haben. Wenn diese Information nur in einem PDF-File liegt, ist sie praktisch nutzlos. Wenn sie im System gemappt ist, lässt sie sich im Handumdrehen finden.
Und das verändert den Wert der gesamten Datenbank grundlegend.
Skill-Extraktion verwandelt Erfahrung in suchbare Signale
Fähigkeiten (Skills) gehören zu den wichtigsten Bestandteilen von Recruiting-Daten, sind aber gleichzeitig der Bereich, den man durch schlechtes Tagging am leichtesten ruinieren kann.
Kandidaten beschreiben ihre Kompetenzen auf unterschiedlichste Weise. Die Dokumentenformate variieren. Die einen haben hervorragend strukturierte Listen von Technologien, die anderen verstecken sie in langen Stellenbeschreibungen. Manche nutzen Abkürzungen, andere die vollen Bezeichnungen.
Der Parser hilft, diese Skills herauszufiltern und als nützliche Tags im System zu vereinheitlichen.
Dies ist entscheidend für die erweiterte Suche, den Aufbau von Talent Pools, das Reporting und zukünftige Projekte. Wenn Skills richtig erfasst werden, können Recruiter schnell auf die Datenbank zugreifen und passende Personen finden, anstatt jedes Mal wieder bei null mit dem externen Sourcing anzufangen.
Aber das ist nicht einfach nur das Hinzufügen von mehr Keywords. Es ist das Erstellen von strukturierten Signalen.
Wenn wir Kompetenzen, Erfahrung, Unternehmen, Sprachen, Standorte und Historie miteinander verknüpfen, entfaltet die Datenbank eine enorme Power. Recruiter können Suchen mit größerer Sicherheit durchführen, Kandidaten effektiver segmentieren und Talente identifizieren, die sonst für immer in den Tiefen alter Dateien verschwunden wären.
Bessere Daten bedeuten bessere Wiederverwendung (Reuse)
Eine Recruiting-Datenbank ist erst dann wertvoll, wenn man sie wiederverwenden kann. Nicht nur für ein einzelnes, aktuelles Projekt, sondern für zukünftige Vakanzen, bei verschiedenen Kunden, zur Pflege von Talent Pools und zum Aufbau langfristiger Beziehungen zu Kandidaten.
Genau in solchen Momenten erweisen sich strukturierte Daten aus dem CV als kritisch. Wenn der Parser Details aus dem Dokument extrahiert, kann der Recruiter auf dieser Basis dynamische Talent Pools erstellen, erweiterte Suchen starten und Top-Profile aus früheren Prozessen identifizieren.
Ohne strukturierte Daten dümpelt der Kandidat zwar im System herum, aber ihn im richtigen Moment an die Oberfläche zu holen, ist extrem mühsam. Und ein Kandidat, den man im entscheidenden Moment nicht finden kann, ist genau so viel wert wie ein Kandidat, den man gar nicht erst in der Datenbank hat.
Das ist einer der Gründe, warum wir der Meinung sind, dass Parsen in erster Linie als Tool zur Sicherung der Datenqualität verstanden werden sollte, und erst in zweiter Linie als Arbeitserleichterung.
Der Parser sichert die Zukunft deiner Datenbank
Die Qualität jeder Recruiting-Datenbank hängt davon aus, wie die Daten in sie hineinkommen.
Wenn dieser Prozess manuell, inkonsistent oder oberflächlich abläuft, wird das System langsam unbrauchbar. Mit der Zeit verlieren Recruiter schlichtweg das Vertrauen darin. Sie kehren zu LinkedIn zurück und investieren in neue Anzeigen, weil die interne Suche unberechenbar wirkt.
Ein guter Parser hilft, das direkt von Anfang an zu verhindern.
Er schafft ein starkes Fundament für das Kandidatenprofil, Firmenbeziehungen, die Standortsuche, Skills, zukünftige Automatisierungen und die Wiederverwendbarkeit der Datenbank. Er hilft dabei, die Nutzbarkeit des Systems nicht nur heute, sondern auch in vielen Monaten und Jahren aufrechtzuerhalten.
Natürlich bedeutet das nicht, dass jedes Profil makellos sein wird. CV-Formate sind unkonventionell. Informationen sind nicht immer vollständig. Die menschliche Überprüfung spielt weiterhin eine wichtige Rolle. Aber das Ziel ist ja nicht, den Recruiter aus dem Prozess auszuschließen. Das Ziel ist es, unnötige, repetitive Routinearbeit zu eliminieren und einen viel besseren Ausgangspunkt zu schaffen.
CV-Parsing ist nicht nur lästige Administration
Es ist sehr leicht, die Einführung eines CV Parsers abzutun, weil es nach rein operativem Handwerk klingt. CV hochladen. Daten extrahieren. Profil erstellen.
In Wirklichkeit berührt dieser Prozess etwas viel Größeres: die Qualität des gesamten Recruiting-Systems.
Wenn die Kandidatendaten schlecht sind, wird die Suche mühsam.
Wenn die Verknüpfungen zu Unternehmen fehlen, hinkt das Markt-Mapping hinterher.
Wenn die Skills nicht vereinheitlicht sind, scheitert das Matchen von Kandidaten.
Wenn der Standort fehlt, werden Filter nutzlos.
Wenn Profile lückenhaft sind, verlieren Talent Pools an Wert.
Wenn die Datenbank kein Vertrauen erweckt – muss das Team wieder von vorn anfangen.
Genau deshalb ist der CV Parser in Recruitify nicht nur ein Tool, um beim Hinzufügen einer Bewerbung ein paar Minuten zu sparen. Er ist der Mechanismus, der dafür sorgt, dass wertvolle Informationen aus dem Lebenslauf nicht in einem toten Dokument stecken bleiben, sondern voll strukturiert, suchbar und mit dem gesamten Ökosystem verknüpft werden.
Warum wir es genau so konzipiert haben
Wir haben unseren CV Parser so gebaut, weil wir wissen, dass Recruiting-Teams bereits über viel mehr Informationen verfügen, als ihnen bewusst ist. Das Problem ist nur, dass der Großteil davon in Dateien, Notizen und verstreuten Postfächern schlummert.
Ein CV sollte kein toter Anhang im System sein. Es sollte aktiv das Kandidatenprofil mitgestalten, die Datenbank anreichern, den geschäftlichen Firmenkontext aufbauen, Direct Search unterstützen, Kompetenzen sowie Standorte ordnen und Recruitern die Arbeit in Zukunft spürbar erleichtern.
Denn Recruiting-Daten haben nur dann einen Wert, wenn man sie jederzeit nutzen kann. Und in dem Moment, in dem das CV als Daten zu arbeiten beginnt, wird der gesamte Recruiting-Prozess zu einem unglaublich eng verzahnten, integrierten Ganzen.
Das war die Vision bei der Entwicklung des CV Parsers in Recruitify: Es geht nicht nur darum, schneller eine neue Profilkarte anzulegen. Es geht darum, intelligente Recruiting-Analysen vom ersten Klick an aufzubauen.
Updates und News
Bleib immer up to date mit den neuesten Innovationen, Features und Tipps rund um Recruitify!
Indem Du Deine E-Mail-Adresse im Anmeldeformular für den Newsletter einträgst, willigst Du in deren Verarbeitung zum Zwecke des Versands von Marketinginformationen über die Produkte und Dienstleistungen des Administrators ein. Der Administrator Deiner zu diesem Zweck verarbeiteten personenbezogenen Daten ist Recruitify Sp. z o.o. mit Sitz in Warschau (KRS 0000709889). Weitere Informationen über die Grundsätze der Verarbeitung personenbezogener Daten und die Rechte der betroffenen Personen findest Du im Dokument Datenschutzerklärung.
Schau dir auch das an

ATS
6 Pflichtfelder für strukturierte Stellenanzeige mit JSON-LD für HR
Praxisanleitung: Welche sechs Pflichtfelder eine Jobseite braucht, kopierbare JSON-LD‑Vorlagen und eine Integrationscheckliste für HR und ATS.
09.09.2026
Mehr erfahren

Dein Rekrutierungsprozess
Scorecards für Interviews mit 3–7 Kriterien: Kalibrieren, DSGVO konform
Praktische Anleitung für Scorecards in Interviews: Kalibrierung, DSGVO konforme Dokumentation, sofort einsetzbare Vorlagen und Recruitify Praxisbeispiele.
08.09.2026
Mehr erfahren
ATS
Fünf Schritte zur Kandidatenreise: HR verkürzt Einstellungsdauer
Praxisleitfaden zur Kandidatenreise für HR: Erstellung in fünf Schritten, sechs Kennzahlen, Benchmarks und sofortige Maßnahmen gegen Abbrüche.
07.09.2026
Mehr erfahren
ATS
6 Pflichtfelder für strukturierte Stellenanzeige mit JSON-LD für HR
Praxisanleitung: Welche sechs Pflichtfelder eine Jobseite braucht, kopierbare JSON-LD‑Vorlagen und eine Integrationscheckliste für HR und ATS.
09.09.2026
Mehr erfahren
Dein Rekrutierungsprozess
Scorecards für Interviews mit 3–7 Kriterien: Kalibrieren, DSGVO konform
Praktische Anleitung für Scorecards in Interviews: Kalibrierung, DSGVO konforme Dokumentation, sofort einsetzbare Vorlagen und Recruitify Praxisbeispiele.
08.09.2026
Mehr erfahren