Päivitetty:
Sisäinen tietokantahaku: näin löydät oikeat ehdokkaat ATS:stä
Rekrytointiprosessi

Recruitify-tiimi
Löydät parhaat ehdokkaat omasta ATS:stä indeksoimalla datan, poistamalla duplikaatit ja käyttämällä boolean- ja kontekstuaalista hakua ihmisen tarkistuksen tukena. Sisäinen tietokantahaku vaatii myös GDPR-suostumusten ja säilytysaikojen dokumentoinnin. Nämä neljä toimenpidettä ratkaisevat suurimman osan rekrytoijien kohtaamista hakuongelmista.
Lyhyesti:
Sisäinen tietokantahaku vaatii kenttien normaalin, yhtenäisen määrittämisen, ja duplikaattien tunnistaminen sähköpostin tai puhelinnumeron avulla on keskeistä.
Hakuprosessissa on tärkeää käyttää boolean- ja kontekstuaalista hakua sekä yhdistää pisteytysmalli ihmisen arvioon varmistaakseen oikeiden ehdokkaiden löytämisen.
Tietosuojan vaatimusten mukaan säilytysaikaa tulee arvioida ja dokumentoida, ja aktiivisten ehdokkaiden tiedot tulee päivittää säännöllisesti.
Recruitify yhdistää ehdokastiedot ja asiakkaan projektit, automatisoi datan strukturoinnin ja hallinnoi GDPR-suostumuksia, mikä nopeuttaa rekrytointiprosessia.
Hakujen optimointiin liittyy tiukka rajaus, hakupohjien tallentaminen ja selkeä käyttöliittymä, joka auttaa välttämään virheitä ja tehostamaan tiimin työskentelyä.
RecruitifyLöydä ehdokkaat omasta tietokannastasiRecruitify yhdistää älykkään indeksoinnin, kontekstuaalisen haun ja GDPR-suostumusten hallinnan samaan rekrytointialustaan.Tutustu Recruitifyhin
Sisällysluettelo
Miten sisäinen tietokantahaku toimii käytännössä: indeksointi ja datan valmistelu
Haku- ja suodatusmenetelmät: boolean, X-ray ja kontekstuaalinen matching
Tietosuoja, suostumukset ja säilytyskäytännöt rekrytoinnissa
Tietokantahaun suorituskyky ja seuranta: mittarit ja parannustoimet
Käytännön checklist: miten otat sisäisen haun käyttöön viikossa
Käyttöliittymän suunnittelu ja käyttäjäkokemus hakujen tukena
Tietokannan ylläpito ja säännöllinen päivittäminen
Hakukyselyiden optimointi ja personointi eri rekrytointitarpeisiin
Integraatiot ulkoisiin järjestelmiin ja datalähteisiin
Esimerkkitapauksia ja parhaita käytäntöjä tehokkaista sisäisistä hauista
Toimittajan näkökulma: tekoälyn rooli rekrytoinnissa ja mitä se tarkoittaa sisäiselle haulle
Miten Recruitify.ai tukee sisäistä tietokantahakua
Lähteet
Usein kysytyt kysymykset
Miten sisäinen tietokantahaku toimii käytännössä: indeksointi ja datan valmistelu
Toimiva tietokantahaku lähtee aina kenttien normalisoinnista. Kannattaa indeksoida ainakin nimi, rooli, tekninen osaaminen, sertifikaatit, viimeisin kontaktipäivä ja suostumusstatus, koska näiden kenttien perusteella haku palauttaa relevantteja tuloksia eikä satunnaisia osumia.
Rakenteellisen datan tuottaminen manuaalisesti on hidasta. AI CV Parser -tyyppinen OCR-teknologia nopeuttaa tätä vaihetta merkittävästi, kun järjestelmä poimii tiedot PDF- tai DOCX-tiedostoista ja skannauksista automaattisesti ja muodostaa niistä strukturoidun profiilin.
Duplikaatit syntyvät, kun samat ehdokkaat tallentuvat tietokantaan useista lähteistä eri kirjoitusasuilla. Tunnistaminen kannattaa perustaa yksilöiviin tunnisteisiin kuten sähköpostiin tai puhelinnumeroon, ja yhdistämissäännöt sekä kirjausketju varmistavat, että yhdistäminen on jäljitettävissä jälkikäteen.
Ensimmäisellä viikolla kannattaa tehdä seuraavat asiat:
Kartoita, mitkä kentät ovat tällä hetkellä puutteellisia tai epäyhtenäisiä.
Määrittele yhtenäinen kenttästandardi koko tiimille.
Aja ensimmäinen duplikaattitarkistus ja dokumentoi yhdistämispäätökset.
Tarkista, että suostumusstatus on merkitty jokaiseen ehdokasprofiiliin.
Haku- ja suodatusmenetelmät: boolean, X-ray ja kontekstuaalinen matching
Boolean-haku on edelleen perusta sisäiselle tietokantahaulle. Operaattorit AND, OR ja NOT yhdistävät taitoja ja rooleja täsmällisesti, esimerkiksi “Java AND Spring NOT junior” rajaa hakua kokeneempiin ehdokkaisiin.
X-ray-tyyppinen lähestymistapa, joka tunnetaan avoimen verkon syväskannauksesta, toimii myös sisäisessä tietokannassa samalla logiikalla: se yhdistää useita hakukriteereitä kerralla, mutta sen tarkkuus riippuu täysin siitä, kuinka hyvin data on aiemmin indeksoitu.
Kontekstuaalinen matching menee avainsanahakua pidemmälle, koska se ymmärtää teknologiaosaamisten väliset yhteydet. Esimerkiksi ehdokas, jolla on kokemusta Kubernetesista, voi sopia rooliin, jossa haetaan Docker-osaamista, vaikka hakusana ei täsmää suoraan.
Käytännössä kannattaa edetä näin:
Määrittele rooliprofiili ja sen pakolliset taidot.
Rakenna boolean-lauseke, joka kattaa synonyymit ja lyhenteet.
Aja kontekstuaalinen haku, joka tuo esiin lähellä olevat profiilit.
Tarkista tuloslista manuaalisesti ennen shortlistin lähettämistä asiakkaalle.
Ammattilaisen vinkki: Yhdistä aina pisteytysmalli ihmisen tarkistukseen: algoritmi tuo esiin ehdokkaat, mutta lopullinen sopivuusarvio kuuluu rekrytoijalle.
Tietosuoja, suostumukset ja säilytyskäytännöt rekrytoinnissa
Rekisterinpitäjän vastuulla on määritellä ja dokumentoida, kuinka pitkään ehdokastietoja säilytetään. Tietosuojavaltuutetun ohjeiden mukaan säilytysaika pitää arvioida etukäteen, ja tiedot on anonymisoitava tai poistettava, kun niitä ei enää tarvita.
Audit trail tarkoittaa käytännössä sitä, että jokaisesta tietueen muutoksesta, suostumuksesta ja poistosta jää jäljitettävä merkintä. Tämä ei ole vain juridinen muoto: se osoittaa myös viranomaiselle, että käsittely on hallittua. Tietosuojavaltuutetun päätökset ovat osoittaneet, että rekrytointijärjestelmien tulee ylläpitää selostetta käsittelytoimista ja määritellä poistoajat selkeästi.
AI-matching rekrytoinnissa luokitellaan korkean riskin tekoälyksi EU:n tekoälyasetuksen liitteen III kohdan mukaisesti, kun järjestelmä analysoi tai pisteyttää hakijoita. Tämä tarkoittaa tiukempia läpinäkyvyys- ja valvontavaatimuksia koko haun ajan.
Käytännön toimenpiteitä:
Anonymisoi profiilit aina, kun ehdokas ei ole aktiivisessa prosessissa.
Minimoi kerättävä data vain rooliin olennaiseen tietoon.
Arvioi säilytysajat säännöllisesti, vähintään vuosittain.
Dokumentoi suostumusten peruutukset samaan audit trailiin kuin niiden antaminen.
Tietokantahaun suorituskyky ja seuranta: mittarit ja parannustoimet
Hakujen toimivuutta ei voi arvioida tunteella, vaan se vaatii mittareita. Keskeisiä ovat palautettujen tulosten määrä per haku, relevanssipistemittaus, duplikaattiaste ja hakuaikojen keskiarvo.
Nämä mittarit kannattaa kerätä testilokeina, jotta pisteytysmallia voi verrata ajan myötä. A/B-testaus toimii hyvin, kun kaksi erilaista hakulauseketta tai pisteytyspainotusta ajetaan samaan rooliprofiiliin ja tuloksia verrataan.
Seurantaa kannattaa tehdä systemaattisesti:
Kirjaa ylös, montako relevanttia ehdokasta haku palautti verrattuna kokonaismäärään.
Seuraa duplikaattiastetta kuukausitasolla.
Raportoi anonymisoidut trendit johdolle, ei yksittäisiä ehdokastietoja.
Käytä raportteja perusteluna sille, mihin tietokannan ylläpitoa kannattaa seuraavaksi kohdistaa.
Käytännön checklist: miten otat sisäisen haun käyttöön viikossa
Viikon mittainen käyttöönotto on realistinen, kun tehtävät jaetaan selkeisiin vaiheisiin.
Päivä 1 ja 2: kartoita nykyinen data, tunnista puutteelliset kentät ja sovi suostumus- ja kenttästandardit tiimin kanssa.
Päivä 3 ja 4: aja OCR-pohjainen parsinta aiemmin käsin syötetylle datalle ja yhdistä duplikaatit yhdistämissääntöjen mukaisesti.
Päivä 5: rakenna hakupohjat yleisimmille rooliprofiileille ja aseta pisteytysmallin painotukset.
Päivä 6 ja 7: testaa hakuja oikeilla rooliprofiileilla, kouluta tiimi ja aseta ensimmäiset seurantamittarit.
Ammattilaisen vinkki: Aloita yhdellä rooliprofiililla, varmista että haku toimii luotettavasti, ja laajenna vasta sitten muihin rooleihin.
Tämä järjestys estää yleisimmän virheen, jossa koko tietokanta yritetään siivota kerralla ja projekti jää kesken.
Käyttöliittymän suunnittelu ja käyttäjäkokemus hakujen tukena
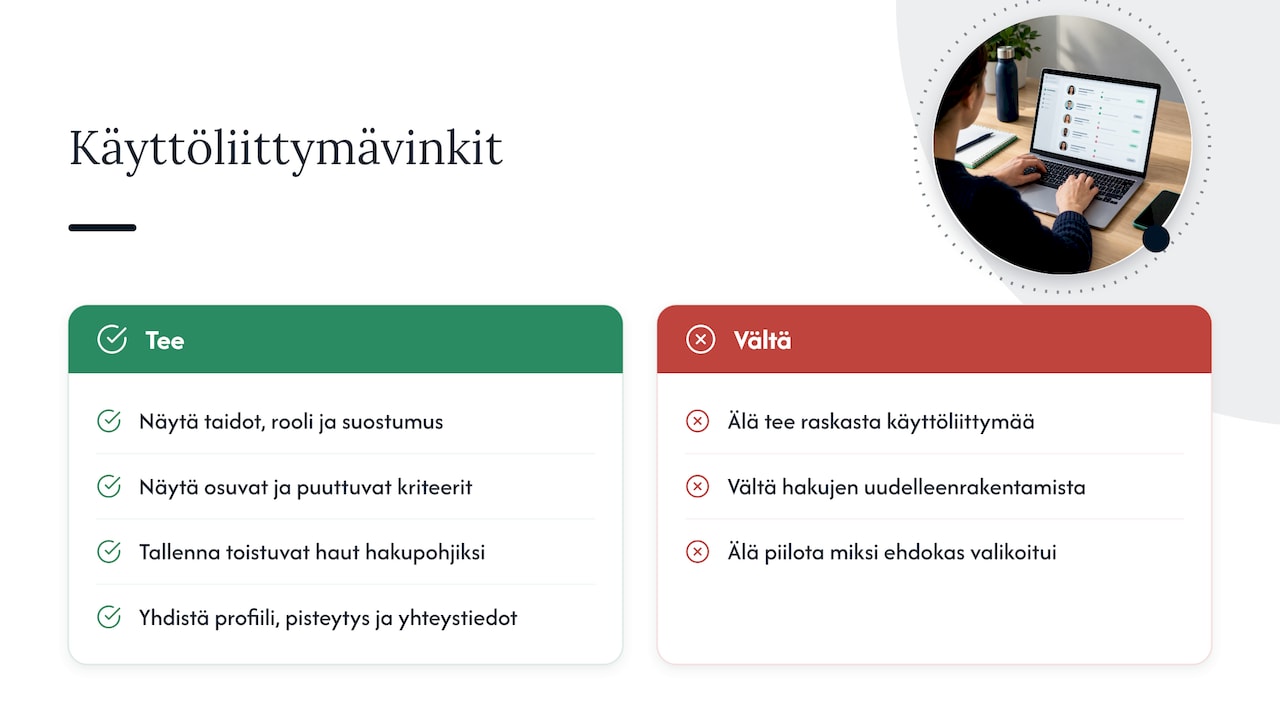
Hakutoiminnon tekninen tarkkuus menee hukkaan, jos käyttöliittymä on raskas käyttää. Selkeä suodatinpaneeli, jossa tekninen osaaminen, rooli ja suostumusstatus näkyvät samalla näkymällä, nopeuttaa rekrytoijan päätöksentekoa huomattavasti.
Hyvä käyttöliittymä näyttää myös, miksi ehdokas nousi hakutuloksiin: mitkä kriteerit täsmäsivät ja mitkä jäivät vajaaksi. Tämä läpinäkyvyys on paitsi käytännöllinen myös osa vastuullista tekoälyn käyttöä, koska rekrytoija pystyy perustelemaan valintansa.
Toistuvat hakutoiminnot kannattaa tallentaa valmiiksi hakupohjiksi, jotta samankaltaisia rooleja ei tarvitse rakentaa alusta joka kerta. Tämä vähentää virheiden riskiä ja nopeuttaa uusien tiimin jäsenten perehdytystä järjestelmään.
Visuaalinen selkeys vaikuttaa myös siihen, kuinka hyvin tiimi havaitsee duplikaatit ja virheelliset tiedot ennen kuin ne päätyvät asiakkaalle esiteltävään listaan. Kun profiilivertailu, pisteytys ja yhteystiedot ovat samassa näkymässä, virheet jäävät kiinni aikaisemmin kuin useiden välilehtien ja taulukoiden välillä hyppiessä.
Tietokannan ylläpito ja säännöllinen päivittäminen
Tietokanta vanhenee nopeasti, jos ehdokastietoja ei päivitetä säännöllisesti. Yhteystiedot muuttuvat, osaamiset kehittyvät ja osa ehdokkaista siirtyy pois työmarkkinoilta kokonaan, mikä heikentää haun luotettavuutta ajan myötä.
Säännöllinen ylläpito kannattaa aikatauluttaa, ei jättää satunnaiseksi tehtäväksi. Neljännesvuosittainen tarkistus, jossa vanhentuneet profiilit merkitään uudelleen tai poistetaan, pitää hakutulokset relevantteina.
Ylläpitoon kuuluu myös suostumusten voimassaolon tarkistaminen. Kun suostumus on vanhentunut tai peruutettu, profiili tulee merkitä sen mukaisesti ennen kuin sitä käytetään uudessa haussa.
Aktiivisten ja passiivisten ehdokkaiden erottelu auttaa myös kohdentamaan ylläpitoresurssit oikein: aktiiviset hakijat vaativat tiiviimpää päivitystä, kun passiivinen talent-pool voidaan tarkistaa harvemmin mutta systemaattisesti.
Hakukyselyiden optimointi ja personointi eri rekrytointitarpeisiin
Eri rekrytointitarpeet vaativat erilaisia hakustrategioita. Kiireellinen operatiivinen rooli hyötyy laajasta boolean-hausta, joka tuo esiin mahdollisimman monta kandidaattia nopeasti, kun taas vaativa asiantuntijarooli hyötyy kontekstuaalisesta matchingista, joka löytää hienovaraisemmat osaamisyhteydet.
Hakulausekkeiden personointi roolin mukaan kannattaa tehdä tallennettavina malleina. Kun sama rooliprofiili toistuu, valmis hakupohja säästää aikaa ja varmistaa, että kriteerit pysyvät yhtenäisinä eri rekrytoijien välillä.
Henkilöstövuokraajan tarpeet poikkeavat suorahakukonsultin tarpeista. Vuokraaja hakee usein nopeasti saatavilla olevia osaajia laajalla kriteerijoukolla, kun suorahaku keskittyy tarkasti rajattuun, harvinaisempaan osaamisprofiiliin.
Hakutulosten personointi voi perustua myös aiempaan sijoitushistoriaan: ehdokkaat, jotka ovat aiemmin menestyneet samankaltaisissa rooleissa, voidaan nostaa esiin painotetummin. Tämä vaatii, että sijoitushistoria on tallennettu samaan tietokantaan kuin muu profiilidata.
Integraatiot ulkoisiin järjestelmiin ja datalähteisiin
Sisäinen tietokanta ei toimi erillään muusta rekrytointiekosysteemistä. Integraatiot sähköpostiin, kalenterijärjestelmiin ja ulkoisiin osaajaverkostoihin tuovat uutta dataa tietokantaan jatkuvasti, mikä pitää sen ajan tasalla manuaalisen syöttötyön sijaan.
Kun ulkoinen datalähde yhdistetään sisäiseen hakuun, normalisointisäännöt tulee soveltaa myös tuontidataan. Muuten integraatio tuo mukanaan uusia duplikaatteja ja epäyhtenäisiä kenttiä, jotka heikentävät hakutulosten laatua.
Myynnin CRM-puolen ja rekrytoinnin ATS-puolen yhdistäminen samaan tietokantaan vähentää myös tiedon pirstaloitumista. Kun asiakastiedot ja ehdokastiedot elävät samassa järjestelmässä, hakutulokset voivat huomioida myös sen, mihin asiakasprojektiin ehdokas aiemmin on liitetty.
Integraatioiden suunnittelussa kannattaa priorisoida lähteet, jotka tuottavat jatkuvasti uutta, luotettavaa dataa, eikä pyrkiä yhdistämään kaikkea mahdollista kerralla. Harvoin päivittyvä ulkoinen lähde tuo enemmän ylläpitotyötä kuin hyötyä.
Esimerkkitapauksia ja parhaita käytäntöjä tehokkaista sisäisistä hauista
Toimiva käytäntö on rajata haku ensin tiukasti ja laajentaa sitä vasta, kun tiukka haku ei tuota tarpeeksi osumia. Tämä järjestys säästää aikaa, koska rekrytoija ei joudu seulomaan satoja epärelevanttia profiilia ennen kuin löytää oikean rajauksen.
Toinen hyväksi havaittu käytäntö on hakupohjien jakaminen tiimin kesken. Kun yksi rekrytoija löytää toimivan boolean-lausekkeen vaikeaan rooliin, sen tallentaminen yhteiseen kirjastoon hyödyttää koko tiimiä seuraavalla kerralla.
Kolmas käytäntö koskee shortlistin laatua ennen asiakkaalle lähettämistä. Anonymisoitu profiili, jossa näkyvät vain osaaminen ja kokemus, auttaa arvioimaan sopivuutta ilman taustatietojen vaikutusta, ja tämä parantaa sekä laatua että prosessin tasa-arvoisuutta.
Yleisin virhe on luottaa pelkkään avainsanahakuun ilman kontekstuaalista tarkistusta. Tämä jättää usein huomiotta ehdokkaat, joiden osaaminen on merkitty eri termillä kuin hakulausekkeessa käytetty, vaikka osaaminen vastaisi tarvetta täysin.
Toimittajan näkökulma: tekoälyn rooli rekrytoinnissa ja mitä se tarkoittaa sisäiselle haulle
Tekoäly ei korvaa rekrytoijan arviota, vaan muuttaa sen sisältöä: työ siirtyy datan seulonnasta laadun ja eettisyyden valvontaan. Kun organisaatio ei tarjoa turvallisia työkaluja sisäiseen hakuun, riski on varjo-IT, jossa tiimi käyttää hallitsemattomia pikaratkaisuja. Teknologiateollisuuden näkemyksen mukaan parempi suunta on hallittu mahdollistaminen: selkeät työkalut ja koulutus kieltojen sijaan. Suostumustenhallinta ja kirjausketju, jollaisia esimerkiksi Recruitify tarjoaa, osoittavat, millaista teknistä tukea tämä hallittu mahdollistaminen käytännössä vaatii.
- Recruitify Team
Miten Recruitify.ai tukee sisäistä tietokantahakua
Sisäisen haun suurin pullonkaula ei ole yleensä data itse, vaan sen hajanaisuus eri taulukoissa ja järjestelmissä. Recruitify yhdistää ATS- ja CRM-toiminnot samaan alustaan, jolloin ehdokastiedot ja asiakasprojektit elävät yhdessä paikassa haun ulottuvilla.
Käytännössä tämä näkyy kolmella tavalla:
AI CV Parser strukturoi ehdokasprofiilit automaattisesti PDF- ja DOCX-tiedostoista ja tunnistaa duplikaatit jo tuontivaiheessa.
Contextual Matching & Scoring yhdistää tech-stack-osaamiset toisiinsa ja tuo esiin sopivuusarviolla varustetut shortlistit.
GDPR-suostumusten hallintamoduuli ylläpitää kirjausketjua jokaisesta tietueesta, mikä helpottaa säilytysaikojen dokumentointia.
Nämä ominaisuudet vähentävät hallinnollisen työn määrää ja nopeuttavat shortlistien kokoamista, kun duplikaatit ja puutteellinen data eivät enää hidasta hakua. Tutustu hinnoittelusivuun ja valitse Starter Package 52 € kuukaudessa käyttäjää kohden tai Agency Package 64 € kuukaudessa käyttäjää kohden omaan tiimiisi sopivan ratkaisun löytämiseksi.
Lähteet
Lisätietoa löytyy EU:n tekoälyasetuksen sivustolta ja Tietosuojavaltuutetun ohjeista.
This article is general information, not a substitute for advice from a qualified lawyer. Consult a qualified legal professional about your own circumstances before acting on anything here.
Usein kysytyt kysymykset
Mitä tarkoittaa sisäinen tietokantahaku rekrytoinnissa?
Sisäinen tietokantahaku tarkoittaa ehdokas- ja CV-tietojen etsimistä omasta ATS- tai talent-pool-järjestelmästä sen sijaan, että haettaisiin uusia ehdokkaita ulkoisista lähteistä. Se perustuu indeksoituun, normalisoituun dataan ja hakutekniikoihin kuten booleaniin ja kontekstuaaliseen matchingiin.
Miten estän duplikaatit ehdokastietokannassa?
Duplikaatit estetään tunnistamalla yksilöivät tunnisteet, kuten sähköposti tai puhelinnumero, ja soveltamalla yhtenäisiä yhdistämissääntöjä. Audit trail varmistaa, että yhdistämispäätökset jäävät jäljitettäviksi myöhempää tarkistusta varten.
Mitä GDPR vaatii sisäiseltä ehdokastietokannalta?
Rekisterinpitäjän on dokumentoitava säilytysajat ja poistettava tai anonymisoitava tiedot, kun niitä ei enää tarvita, Tietosuojavaltuutetun ohjeiden mukaisesti. AI-pohjainen hakijoiden pisteytys voi lisäksi luokittua korkean riskin tekoälyksi EU:n tekoälyasetuksen nojalla, mikä tuo lisävaatimuksia läpinäkyvyydelle ja valvonnalle.
Mitä Recruitify.ai maksaa?
Recruitify tarjoaa Starter Packagen hintaan 52 € kuukaudessa käyttäjää kohden ja Agency Packagen hintaan 64 € kuukaudessa käyttäjää kohden, hinnoittelusivun mukaisesti. Enterprise Packagen hinta on saatavilla erikseen pyydettäessä.
Suositukset
Päivitykset ja uutuudet
Pysy ajan tasalla uusimpien innovaatioiden, ominaisuuksien ja vinkkien kanssa koskien Recruitify-sovellusta!
Antaessasi sähköpostiosoitteesi uutiskirjeen tilaamisen yhteydessä suostut sen käsittelyyn markkinointitietojen lähettämiseksi koskien Administraattorin tuotteita ja palveluita. Henkilötietojesi käsittelijä yllä olevaan tarkoitukseen on Recruitify Sp. z o.o., jonka päätoimipaikka on Varsovassa (KRS 0000709889). Lisätietoja henkilötietojen käsittelyn periaatteista ja niihin liittyvien henkilöiden oikeuksista löydät asiakirjasta Tietosuojakäytäntö.

Päivitetty:
Sisäinen tietokantahaku: näin löydät oikeat ehdokkaat ATS:stä
Rekrytointiprosessi
Recruitify-tiimi
Löydät parhaat ehdokkaat omasta ATS:stä indeksoimalla datan, poistamalla duplikaatit ja käyttämällä boolean- ja kontekstuaalista hakua ihmisen tarkistuksen tukena. Sisäinen tietokantahaku vaatii myös GDPR-suostumusten ja säilytysaikojen dokumentoinnin. Nämä neljä toimenpidettä ratkaisevat suurimman osan rekrytoijien kohtaamista hakuongelmista.
Lyhyesti:
Sisäinen tietokantahaku vaatii kenttien normaalin, yhtenäisen määrittämisen, ja duplikaattien tunnistaminen sähköpostin tai puhelinnumeron avulla on keskeistä.
Hakuprosessissa on tärkeää käyttää boolean- ja kontekstuaalista hakua sekä yhdistää pisteytysmalli ihmisen arvioon varmistaakseen oikeiden ehdokkaiden löytämisen.
Tietosuojan vaatimusten mukaan säilytysaikaa tulee arvioida ja dokumentoida, ja aktiivisten ehdokkaiden tiedot tulee päivittää säännöllisesti.
Recruitify yhdistää ehdokastiedot ja asiakkaan projektit, automatisoi datan strukturoinnin ja hallinnoi GDPR-suostumuksia, mikä nopeuttaa rekrytointiprosessia.
Hakujen optimointiin liittyy tiukka rajaus, hakupohjien tallentaminen ja selkeä käyttöliittymä, joka auttaa välttämään virheitä ja tehostamaan tiimin työskentelyä.
RecruitifyLöydä ehdokkaat omasta tietokannastasiRecruitify yhdistää älykkään indeksoinnin, kontekstuaalisen haun ja GDPR-suostumusten hallinnan samaan rekrytointialustaan.Tutustu Recruitifyhin
Sisällysluettelo
Miten sisäinen tietokantahaku toimii käytännössä: indeksointi ja datan valmistelu
Haku- ja suodatusmenetelmät: boolean, X-ray ja kontekstuaalinen matching
Tietosuoja, suostumukset ja säilytyskäytännöt rekrytoinnissa
Tietokantahaun suorituskyky ja seuranta: mittarit ja parannustoimet
Käytännön checklist: miten otat sisäisen haun käyttöön viikossa
Käyttöliittymän suunnittelu ja käyttäjäkokemus hakujen tukena
Tietokannan ylläpito ja säännöllinen päivittäminen
Hakukyselyiden optimointi ja personointi eri rekrytointitarpeisiin
Integraatiot ulkoisiin järjestelmiin ja datalähteisiin
Esimerkkitapauksia ja parhaita käytäntöjä tehokkaista sisäisistä hauista
Toimittajan näkökulma: tekoälyn rooli rekrytoinnissa ja mitä se tarkoittaa sisäiselle haulle
Miten Recruitify.ai tukee sisäistä tietokantahakua
Lähteet
Usein kysytyt kysymykset
Miten sisäinen tietokantahaku toimii käytännössä: indeksointi ja datan valmistelu
Toimiva tietokantahaku lähtee aina kenttien normalisoinnista. Kannattaa indeksoida ainakin nimi, rooli, tekninen osaaminen, sertifikaatit, viimeisin kontaktipäivä ja suostumusstatus, koska näiden kenttien perusteella haku palauttaa relevantteja tuloksia eikä satunnaisia osumia.
Rakenteellisen datan tuottaminen manuaalisesti on hidasta. AI CV Parser -tyyppinen OCR-teknologia nopeuttaa tätä vaihetta merkittävästi, kun järjestelmä poimii tiedot PDF- tai DOCX-tiedostoista ja skannauksista automaattisesti ja muodostaa niistä strukturoidun profiilin.
Duplikaatit syntyvät, kun samat ehdokkaat tallentuvat tietokantaan useista lähteistä eri kirjoitusasuilla. Tunnistaminen kannattaa perustaa yksilöiviin tunnisteisiin kuten sähköpostiin tai puhelinnumeroon, ja yhdistämissäännöt sekä kirjausketju varmistavat, että yhdistäminen on jäljitettävissä jälkikäteen.
Ensimmäisellä viikolla kannattaa tehdä seuraavat asiat:
Kartoita, mitkä kentät ovat tällä hetkellä puutteellisia tai epäyhtenäisiä.
Määrittele yhtenäinen kenttästandardi koko tiimille.
Aja ensimmäinen duplikaattitarkistus ja dokumentoi yhdistämispäätökset.
Tarkista, että suostumusstatus on merkitty jokaiseen ehdokasprofiiliin.
Haku- ja suodatusmenetelmät: boolean, X-ray ja kontekstuaalinen matching
Boolean-haku on edelleen perusta sisäiselle tietokantahaulle. Operaattorit AND, OR ja NOT yhdistävät taitoja ja rooleja täsmällisesti, esimerkiksi “Java AND Spring NOT junior” rajaa hakua kokeneempiin ehdokkaisiin.
X-ray-tyyppinen lähestymistapa, joka tunnetaan avoimen verkon syväskannauksesta, toimii myös sisäisessä tietokannassa samalla logiikalla: se yhdistää useita hakukriteereitä kerralla, mutta sen tarkkuus riippuu täysin siitä, kuinka hyvin data on aiemmin indeksoitu.
Kontekstuaalinen matching menee avainsanahakua pidemmälle, koska se ymmärtää teknologiaosaamisten väliset yhteydet. Esimerkiksi ehdokas, jolla on kokemusta Kubernetesista, voi sopia rooliin, jossa haetaan Docker-osaamista, vaikka hakusana ei täsmää suoraan.
Käytännössä kannattaa edetä näin:
Määrittele rooliprofiili ja sen pakolliset taidot.
Rakenna boolean-lauseke, joka kattaa synonyymit ja lyhenteet.
Aja kontekstuaalinen haku, joka tuo esiin lähellä olevat profiilit.
Tarkista tuloslista manuaalisesti ennen shortlistin lähettämistä asiakkaalle.
Ammattilaisen vinkki: Yhdistä aina pisteytysmalli ihmisen tarkistukseen: algoritmi tuo esiin ehdokkaat, mutta lopullinen sopivuusarvio kuuluu rekrytoijalle.
Tietosuoja, suostumukset ja säilytyskäytännöt rekrytoinnissa
Rekisterinpitäjän vastuulla on määritellä ja dokumentoida, kuinka pitkään ehdokastietoja säilytetään. Tietosuojavaltuutetun ohjeiden mukaan säilytysaika pitää arvioida etukäteen, ja tiedot on anonymisoitava tai poistettava, kun niitä ei enää tarvita.
Audit trail tarkoittaa käytännössä sitä, että jokaisesta tietueen muutoksesta, suostumuksesta ja poistosta jää jäljitettävä merkintä. Tämä ei ole vain juridinen muoto: se osoittaa myös viranomaiselle, että käsittely on hallittua. Tietosuojavaltuutetun päätökset ovat osoittaneet, että rekrytointijärjestelmien tulee ylläpitää selostetta käsittelytoimista ja määritellä poistoajat selkeästi.
AI-matching rekrytoinnissa luokitellaan korkean riskin tekoälyksi EU:n tekoälyasetuksen liitteen III kohdan mukaisesti, kun järjestelmä analysoi tai pisteyttää hakijoita. Tämä tarkoittaa tiukempia läpinäkyvyys- ja valvontavaatimuksia koko haun ajan.
Käytännön toimenpiteitä:
Anonymisoi profiilit aina, kun ehdokas ei ole aktiivisessa prosessissa.
Minimoi kerättävä data vain rooliin olennaiseen tietoon.
Arvioi säilytysajat säännöllisesti, vähintään vuosittain.
Dokumentoi suostumusten peruutukset samaan audit trailiin kuin niiden antaminen.
Tietokantahaun suorituskyky ja seuranta: mittarit ja parannustoimet
Hakujen toimivuutta ei voi arvioida tunteella, vaan se vaatii mittareita. Keskeisiä ovat palautettujen tulosten määrä per haku, relevanssipistemittaus, duplikaattiaste ja hakuaikojen keskiarvo.
Nämä mittarit kannattaa kerätä testilokeina, jotta pisteytysmallia voi verrata ajan myötä. A/B-testaus toimii hyvin, kun kaksi erilaista hakulauseketta tai pisteytyspainotusta ajetaan samaan rooliprofiiliin ja tuloksia verrataan.
Seurantaa kannattaa tehdä systemaattisesti:
Kirjaa ylös, montako relevanttia ehdokasta haku palautti verrattuna kokonaismäärään.
Seuraa duplikaattiastetta kuukausitasolla.
Raportoi anonymisoidut trendit johdolle, ei yksittäisiä ehdokastietoja.
Käytä raportteja perusteluna sille, mihin tietokannan ylläpitoa kannattaa seuraavaksi kohdistaa.
Käytännön checklist: miten otat sisäisen haun käyttöön viikossa
Viikon mittainen käyttöönotto on realistinen, kun tehtävät jaetaan selkeisiin vaiheisiin.
Päivä 1 ja 2: kartoita nykyinen data, tunnista puutteelliset kentät ja sovi suostumus- ja kenttästandardit tiimin kanssa.
Päivä 3 ja 4: aja OCR-pohjainen parsinta aiemmin käsin syötetylle datalle ja yhdistä duplikaatit yhdistämissääntöjen mukaisesti.
Päivä 5: rakenna hakupohjat yleisimmille rooliprofiileille ja aseta pisteytysmallin painotukset.
Päivä 6 ja 7: testaa hakuja oikeilla rooliprofiileilla, kouluta tiimi ja aseta ensimmäiset seurantamittarit.
Ammattilaisen vinkki: Aloita yhdellä rooliprofiililla, varmista että haku toimii luotettavasti, ja laajenna vasta sitten muihin rooleihin.
Tämä järjestys estää yleisimmän virheen, jossa koko tietokanta yritetään siivota kerralla ja projekti jää kesken.
Käyttöliittymän suunnittelu ja käyttäjäkokemus hakujen tukena
Hakutoiminnon tekninen tarkkuus menee hukkaan, jos käyttöliittymä on raskas käyttää. Selkeä suodatinpaneeli, jossa tekninen osaaminen, rooli ja suostumusstatus näkyvät samalla näkymällä, nopeuttaa rekrytoijan päätöksentekoa huomattavasti.
Hyvä käyttöliittymä näyttää myös, miksi ehdokas nousi hakutuloksiin: mitkä kriteerit täsmäsivät ja mitkä jäivät vajaaksi. Tämä läpinäkyvyys on paitsi käytännöllinen myös osa vastuullista tekoälyn käyttöä, koska rekrytoija pystyy perustelemaan valintansa.
Toistuvat hakutoiminnot kannattaa tallentaa valmiiksi hakupohjiksi, jotta samankaltaisia rooleja ei tarvitse rakentaa alusta joka kerta. Tämä vähentää virheiden riskiä ja nopeuttaa uusien tiimin jäsenten perehdytystä järjestelmään.
Visuaalinen selkeys vaikuttaa myös siihen, kuinka hyvin tiimi havaitsee duplikaatit ja virheelliset tiedot ennen kuin ne päätyvät asiakkaalle esiteltävään listaan. Kun profiilivertailu, pisteytys ja yhteystiedot ovat samassa näkymässä, virheet jäävät kiinni aikaisemmin kuin useiden välilehtien ja taulukoiden välillä hyppiessä.
Tietokannan ylläpito ja säännöllinen päivittäminen
Tietokanta vanhenee nopeasti, jos ehdokastietoja ei päivitetä säännöllisesti. Yhteystiedot muuttuvat, osaamiset kehittyvät ja osa ehdokkaista siirtyy pois työmarkkinoilta kokonaan, mikä heikentää haun luotettavuutta ajan myötä.
Säännöllinen ylläpito kannattaa aikatauluttaa, ei jättää satunnaiseksi tehtäväksi. Neljännesvuosittainen tarkistus, jossa vanhentuneet profiilit merkitään uudelleen tai poistetaan, pitää hakutulokset relevantteina.
Ylläpitoon kuuluu myös suostumusten voimassaolon tarkistaminen. Kun suostumus on vanhentunut tai peruutettu, profiili tulee merkitä sen mukaisesti ennen kuin sitä käytetään uudessa haussa.
Aktiivisten ja passiivisten ehdokkaiden erottelu auttaa myös kohdentamaan ylläpitoresurssit oikein: aktiiviset hakijat vaativat tiiviimpää päivitystä, kun passiivinen talent-pool voidaan tarkistaa harvemmin mutta systemaattisesti.
Hakukyselyiden optimointi ja personointi eri rekrytointitarpeisiin
Eri rekrytointitarpeet vaativat erilaisia hakustrategioita. Kiireellinen operatiivinen rooli hyötyy laajasta boolean-hausta, joka tuo esiin mahdollisimman monta kandidaattia nopeasti, kun taas vaativa asiantuntijarooli hyötyy kontekstuaalisesta matchingista, joka löytää hienovaraisemmat osaamisyhteydet.
Hakulausekkeiden personointi roolin mukaan kannattaa tehdä tallennettavina malleina. Kun sama rooliprofiili toistuu, valmis hakupohja säästää aikaa ja varmistaa, että kriteerit pysyvät yhtenäisinä eri rekrytoijien välillä.
Henkilöstövuokraajan tarpeet poikkeavat suorahakukonsultin tarpeista. Vuokraaja hakee usein nopeasti saatavilla olevia osaajia laajalla kriteerijoukolla, kun suorahaku keskittyy tarkasti rajattuun, harvinaisempaan osaamisprofiiliin.
Hakutulosten personointi voi perustua myös aiempaan sijoitushistoriaan: ehdokkaat, jotka ovat aiemmin menestyneet samankaltaisissa rooleissa, voidaan nostaa esiin painotetummin. Tämä vaatii, että sijoitushistoria on tallennettu samaan tietokantaan kuin muu profiilidata.
Integraatiot ulkoisiin järjestelmiin ja datalähteisiin
Sisäinen tietokanta ei toimi erillään muusta rekrytointiekosysteemistä. Integraatiot sähköpostiin, kalenterijärjestelmiin ja ulkoisiin osaajaverkostoihin tuovat uutta dataa tietokantaan jatkuvasti, mikä pitää sen ajan tasalla manuaalisen syöttötyön sijaan.
Kun ulkoinen datalähde yhdistetään sisäiseen hakuun, normalisointisäännöt tulee soveltaa myös tuontidataan. Muuten integraatio tuo mukanaan uusia duplikaatteja ja epäyhtenäisiä kenttiä, jotka heikentävät hakutulosten laatua.
Myynnin CRM-puolen ja rekrytoinnin ATS-puolen yhdistäminen samaan tietokantaan vähentää myös tiedon pirstaloitumista. Kun asiakastiedot ja ehdokastiedot elävät samassa järjestelmässä, hakutulokset voivat huomioida myös sen, mihin asiakasprojektiin ehdokas aiemmin on liitetty.
Integraatioiden suunnittelussa kannattaa priorisoida lähteet, jotka tuottavat jatkuvasti uutta, luotettavaa dataa, eikä pyrkiä yhdistämään kaikkea mahdollista kerralla. Harvoin päivittyvä ulkoinen lähde tuo enemmän ylläpitotyötä kuin hyötyä.
Esimerkkitapauksia ja parhaita käytäntöjä tehokkaista sisäisistä hauista
Toimiva käytäntö on rajata haku ensin tiukasti ja laajentaa sitä vasta, kun tiukka haku ei tuota tarpeeksi osumia. Tämä järjestys säästää aikaa, koska rekrytoija ei joudu seulomaan satoja epärelevanttia profiilia ennen kuin löytää oikean rajauksen.
Toinen hyväksi havaittu käytäntö on hakupohjien jakaminen tiimin kesken. Kun yksi rekrytoija löytää toimivan boolean-lausekkeen vaikeaan rooliin, sen tallentaminen yhteiseen kirjastoon hyödyttää koko tiimiä seuraavalla kerralla.
Kolmas käytäntö koskee shortlistin laatua ennen asiakkaalle lähettämistä. Anonymisoitu profiili, jossa näkyvät vain osaaminen ja kokemus, auttaa arvioimaan sopivuutta ilman taustatietojen vaikutusta, ja tämä parantaa sekä laatua että prosessin tasa-arvoisuutta.
Yleisin virhe on luottaa pelkkään avainsanahakuun ilman kontekstuaalista tarkistusta. Tämä jättää usein huomiotta ehdokkaat, joiden osaaminen on merkitty eri termillä kuin hakulausekkeessa käytetty, vaikka osaaminen vastaisi tarvetta täysin.
Toimittajan näkökulma: tekoälyn rooli rekrytoinnissa ja mitä se tarkoittaa sisäiselle haulle
Tekoäly ei korvaa rekrytoijan arviota, vaan muuttaa sen sisältöä: työ siirtyy datan seulonnasta laadun ja eettisyyden valvontaan. Kun organisaatio ei tarjoa turvallisia työkaluja sisäiseen hakuun, riski on varjo-IT, jossa tiimi käyttää hallitsemattomia pikaratkaisuja. Teknologiateollisuuden näkemyksen mukaan parempi suunta on hallittu mahdollistaminen: selkeät työkalut ja koulutus kieltojen sijaan. Suostumustenhallinta ja kirjausketju, jollaisia esimerkiksi Recruitify tarjoaa, osoittavat, millaista teknistä tukea tämä hallittu mahdollistaminen käytännössä vaatii.
- Recruitify Team
Miten Recruitify.ai tukee sisäistä tietokantahakua
Sisäisen haun suurin pullonkaula ei ole yleensä data itse, vaan sen hajanaisuus eri taulukoissa ja järjestelmissä. Recruitify yhdistää ATS- ja CRM-toiminnot samaan alustaan, jolloin ehdokastiedot ja asiakasprojektit elävät yhdessä paikassa haun ulottuvilla.
Käytännössä tämä näkyy kolmella tavalla:
AI CV Parser strukturoi ehdokasprofiilit automaattisesti PDF- ja DOCX-tiedostoista ja tunnistaa duplikaatit jo tuontivaiheessa.
Contextual Matching & Scoring yhdistää tech-stack-osaamiset toisiinsa ja tuo esiin sopivuusarviolla varustetut shortlistit.
GDPR-suostumusten hallintamoduuli ylläpitää kirjausketjua jokaisesta tietueesta, mikä helpottaa säilytysaikojen dokumentointia.
Nämä ominaisuudet vähentävät hallinnollisen työn määrää ja nopeuttavat shortlistien kokoamista, kun duplikaatit ja puutteellinen data eivät enää hidasta hakua. Tutustu hinnoittelusivuun ja valitse Starter Package 52 € kuukaudessa käyttäjää kohden tai Agency Package 64 € kuukaudessa käyttäjää kohden omaan tiimiisi sopivan ratkaisun löytämiseksi.
Lähteet
Lisätietoa löytyy EU:n tekoälyasetuksen sivustolta ja Tietosuojavaltuutetun ohjeista.
This article is general information, not a substitute for advice from a qualified lawyer. Consult a qualified legal professional about your own circumstances before acting on anything here.
Usein kysytyt kysymykset
Mitä tarkoittaa sisäinen tietokantahaku rekrytoinnissa?
Sisäinen tietokantahaku tarkoittaa ehdokas- ja CV-tietojen etsimistä omasta ATS- tai talent-pool-järjestelmästä sen sijaan, että haettaisiin uusia ehdokkaita ulkoisista lähteistä. Se perustuu indeksoituun, normalisoituun dataan ja hakutekniikoihin kuten booleaniin ja kontekstuaaliseen matchingiin.
Miten estän duplikaatit ehdokastietokannassa?
Duplikaatit estetään tunnistamalla yksilöivät tunnisteet, kuten sähköposti tai puhelinnumero, ja soveltamalla yhtenäisiä yhdistämissääntöjä. Audit trail varmistaa, että yhdistämispäätökset jäävät jäljitettäviksi myöhempää tarkistusta varten.
Mitä GDPR vaatii sisäiseltä ehdokastietokannalta?
Rekisterinpitäjän on dokumentoitava säilytysajat ja poistettava tai anonymisoitava tiedot, kun niitä ei enää tarvita, Tietosuojavaltuutetun ohjeiden mukaisesti. AI-pohjainen hakijoiden pisteytys voi lisäksi luokittua korkean riskin tekoälyksi EU:n tekoälyasetuksen nojalla, mikä tuo lisävaatimuksia läpinäkyvyydelle ja valvonnalle.
Mitä Recruitify.ai maksaa?
Recruitify tarjoaa Starter Packagen hintaan 52 € kuukaudessa käyttäjää kohden ja Agency Packagen hintaan 64 € kuukaudessa käyttäjää kohden, hinnoittelusivun mukaisesti. Enterprise Packagen hinta on saatavilla erikseen pyydettäessä.
Suositukset
Päivitykset ja uutuudet
Pysy ajan tasalla uusimpien innovaatioiden, ominaisuuksien ja vinkkien kanssa koskien Recruitify-sovellusta!
Antaessasi sähköpostiosoitteesi uutiskirjeen tilaamisen yhteydessä suostut sen käsittelyyn markkinointitietojen lähettämiseksi koskien Administraattorin tuotteita ja palveluita. Henkilötietojesi käsittelijä yllä olevaan tarkoitukseen on Recruitify Sp. z o.o., jonka päätoimipaikka on Varsovassa (KRS 0000709889). Lisätietoja henkilötietojen käsittelyn periaatteista ja niihin liittyvien henkilöiden oikeuksista löydät asiakirjasta Tietosuojakäytäntö.
Tutustu myös
Kykyjen hankinta
Datalaatu rekrytoinnissa: näin varmistat oikean ja vaatimustenmukaisen datan
Paranna rekrytoinnin datalaatua ja varmista vaatimustenmukaisuus: käytä GDPR:n mukaista käsittelyä, systemaattista deduplikointia ja dokumentoitua...
5.10.2026
Näytä lisää
Rekrytointiprosessi
Toimintasuositukset HR: miten organisoida ja ulkoistaa pk-yrityksessä
Opi henkilöstöhallinnon toimintasuosituksista: korjaa lakisääteiset prosessit, nimeä sisäinen omistaja ja ulkoista rutiinit vaiheittain pilottien avulla.
4.10.2026
Näytä lisää
Uutiset
Suorahaku automaatio: mitä kannattaa automatisoida ensin
Suorahakuautomaation avulla automatisoi cv:n seulonta, hakijoiden etsintä ja alkuviestintä, vähennä hallintotyötä ja vapauta rekrytoijan aika aloittamalla...
2.10.2026
Näytä lisää
Kykyjen hankinta
Datalaatu rekrytoinnissa: näin varmistat oikean ja vaatimustenmukaisen datan
Paranna rekrytoinnin datalaatua ja varmista vaatimustenmukaisuus: käytä GDPR:n mukaista käsittelyä, systemaattista deduplikointia ja dokumentoitua...
5.10.2026
Näytä lisää
Rekrytointiprosessi
Toimintasuositukset HR: miten organisoida ja ulkoistaa pk-yrityksessä
Opi henkilöstöhallinnon toimintasuosituksista: korjaa lakisääteiset prosessit, nimeä sisäinen omistaja ja ulkoista rutiinit vaiheittain pilottien avulla.
4.10.2026
Näytä lisää