Päivitetty:
Rekrytointiputken ennustaminen: näin ennakoit tarpeet ajoissa
Rekrytointiprosessi

Recruitify-tiimi
Rekrytointiputken ennustaminen tarkoittaa, että mittaamme vaiheiden välisiä konversioita ja kapasiteettia ennen kuin täyttötarve muuttuu akuutiksi ongelmaksi. Se vähentää hätäpohjaista rekrytointia ja parantaa täyttöasteita, kun päätökset perustuvat dataan arvailun sijaan. Nopein käytännön alku on yksinkertainen tilastollinen malli, joka rakennetaan ATS- ja CRM-datan pohjalta, ja jota voi myöhemmin laajentaa koneoppimiseen.
Lyhyesti:
Ennustava rekrytointiputki vaatii tarkkaa datan keräämistä ja laadun varmistamista, erityisesti vaiheiden välisissä konversioissa ja aikaleimoissa.
Menetelmät kuten tilastolliset mallit ja Monte Carlo -simulaatiot sopivat paremmin vakaaseen dataan, mutta koneoppiminen vaatii suurempia datamääriä ja ylläpitoa.
Pilotin kannattaa aloittaa yhdestä segmentistä ja käyttää testausta sekä backtestausta mallin luotettavuuden arvioimiseksi ennen laajentamista.
EU:n AI Act ja GDPR asettavat ennustusjärjestelmille tiukkoja läpinäkyvyys- ja auditoimivaatimuksia, jotka edellyttävät selkeää dokumentaatiota ja suostumusprosessia.
Ennustemallien toteutus sujuu nopeammin, kun järjestelmät kuten ATS ja CRM ovat integroitu samoihin alustoihin, mikä vähentää datayhdistämiseen kuluvaa aikaa.
RecruitifyEnnakoi rekrytointitarpeet yhdestä näkymästäRecruitify yhdistää ATS:n, myynnin CRM:n ja analytiikan, jotta rekrytointiputken tiedot pysyvät samassa toimintaympäristössä.Tutustu Recruitifyhin
Sisällysluettelo
Mitä tarkoittaa rekrytointiputken ennustaminen ja milloin sitä tarvitaan
Keskeiset mittarit ja datalähteet, joita ennustukseen tarvitaan
Menetelmät: tilastollisista malleista Monte Carloon ja koneoppimiseen
Käytännön implementaatio: vaiheittainen opas datasta tuotokseen
Riskit, sääntely ja eettinen hallinta: EU AI Act ja GDPR käytännössä
Käytännön esimerkki: näin integroitu alusta auttaa ennustamisessa
Toimialanäkökulma: miksi siirtyä ennakoivaan rekrytointiin nyt
Miten Recruitify.ai voi nopeuttaa rekrytointiputken ennustamista
Usein kysytyt kysymykset
Lähteet
Mitä tarkoittaa rekrytointiputken ennustaminen ja milloin sitä tarvitaan
Rekrytointiputken ennustaminen tarkoittaa menneen datan ja nykyisten signaalien käyttöä tulevien täyttötarpeiden, konversioiden ja aikataulujen arvioimiseksi. Käytännössä kyse on kolmesta eri analytiikan tasosta, jotka CIPD:n people analytics -viitekehys erottaa toisistaan selvästi.
Kuvaileva analytiikka kertoo, mitä on tapahtunut: kuinka monta hakemusta vastaanotimme viime kuussa tai mikä oli keskimääräinen rekrytointiaika. Ennustava analytiikka menee pidemmälle ja arvioi, mitä todennäköisesti tapahtuu seuraavaksi nykyisten trendien perusteella. Ohjeistava analytiikka taas suosittelee konkreettisia toimia: montako uutta kandidaattia putkeen tarvitaan, jotta tavoiteltu täyttömäärä toteutuu.
Ennustaminen tuo eniten arvoa silloin, kun rekrytointivolyymi on suuri, organisaatio kasvaa nopeasti tai henkilöstön vaihtuvuus on korkea. Pienessä, tasaisessa rekrytointivirrassa yksinkertainen seuranta usein riittää.
Tyypillisiä tilanteita, joissa ennustaminen kannattaa:
Kausivaihtelu vaikuttaa hakijamääriin ja täyttöaikoihin merkittävästi.
Useita rooleja täytetään samanaikaisesti rajallisilla rekrytointiresursseilla.
Liiketoiminta kasvaa nopeasti ja henkilöstötarve muuttuu kuukausittain.
Vaihtuvuus tietyssä roolissa tai yksikössä on toistuvasti korkea.
CIPD:n resursointiraportit osoittavat, että moni organisaatio kerää rekrytointidataa, mutta vain harva laskee prosessiensa tuottoa tai käyttää strukturoitua ennustamista systemaattisesti.
Keskeiset mittarit ja datalähteet, joita ennustukseen tarvitaan
Toimiva ennustemalli tarvitsee tarkasti määritellyt mittarit ja luotettavan datapohjan. Ilman niitä paras algoritmikaan ei tuota käyttökelpoisia tuloksia.
Kriittisimmät mittarit ovat seuraavat:
Pipeline velocity, eli nopeus, jolla kandidaatit etenevät vaiheesta toiseen.
Vaiheiden väliset konversioprosentit, esimerkiksi hakemuksesta haastatteluun ja haastattelusta tarjoukseen.
Time-to-hire, kokonaisaika ensimmäisestä kontaktista allekirjoitettuun sopimukseen.
Lead-to-hire-suhde, joka kertoo kuinka suuri osa liideistä päätyy palkkaukseen.
Lähteen laatu (source quality), eli mistä kanavista tulevat kandidaatit etenevät parhaiten.
Näitä tietoja kerätään useasta järjestelmästä: ATS tallentaa hakemusten ja vaiheiden historian, CRM kertoo liidien ja asiakassuhteiden tilan, HRIS tuo organisaatiorakenteen ja henkilöstötiedot, ja arviointijärjestelmät tuottavat laatua kuvaavaa dataa haastatteluista. Ulkoiset indikaattorit, kuten toimialan työmarkkinatilanne, täydentävät kuvaa mutta harvoin korvaavat sisäistä dataa.
Datan laatu on usein suurin käytännön este. Duplikaattiprofiilit vääristävät konversiolaskelmia, puuttuvat tai epäjohdonmukaiset aikaleimat tekevät time-to-hire-mittauksesta epäluotettavan, ja standardoimattomat kentät (esimerkiksi vapaamuotoiset tekstikentät roolin sijaan) vaikeuttavat vaiheiden vertailua eri tiimien välillä. Näihin ongelmiin kannattaa vastata ennen mallinnuksen aloittamista: yhtenäistä kenttästandardit, poista duplikaatit automaattisesti ja varmista, että jokainen vaihemuutos kirjataan aikaleimalla.
Ammattilaisen vinkki: Aloita yhdestä putken segmentistä, esimerkiksi yhdestä roolityypistä, ennen koko organisaation kattavaa mittaristoa: se paljastaa datan puutteet nopeasti ja halvalla.
Menetelmät: tilastollisista malleista Monte Carloon ja koneoppimiseen
Ennustusmenetelmät jakautuvat karkeasti kolmeen ryhmään, joilla jokaisella on oma datavaatimuksensa ja käyttötarkoituksensa.
Yksinkertaiset tilastolliset mallit, kuten liukuvat keskiarvot tai perinteiset aikasarjamallit, soveltuvat hyvin silloin, kun historiadataa on kohtuullisesti ja prosessi on suhteellisen vakaa. Ne ovat läpinäkyviä ja helposti selitettäviä, mikä on etu sekä johdolle että auditoinneille.
Monte Carlo -simulaatio tuo mukaan epävarmuuden kvantifioinnin: sen sijaan, että ennustaisimme yhden luvun, se tuottaa todennäköisyysjakauman mahdollisista lopputuloksista satoja tai tuhansia kertoja toistetun satunnaisotannan avulla. Aalto-yliopiston tapaustutkimus osoittaa menetelmän hyödyllisyyden myyntiprosessin ennustamisessa, ja samaa logiikkaa voi soveltaa rekrytointiputkeen silloin, kun vaiheittainen konversiodata on riittävän kattavaa. Ilman hyvää vaiheittaista dataa simulointi tuottaa kuitenkin hyvin laajoja epävarmuusalueita, jolloin sen käytännön hyöty jää vähäiseksi.
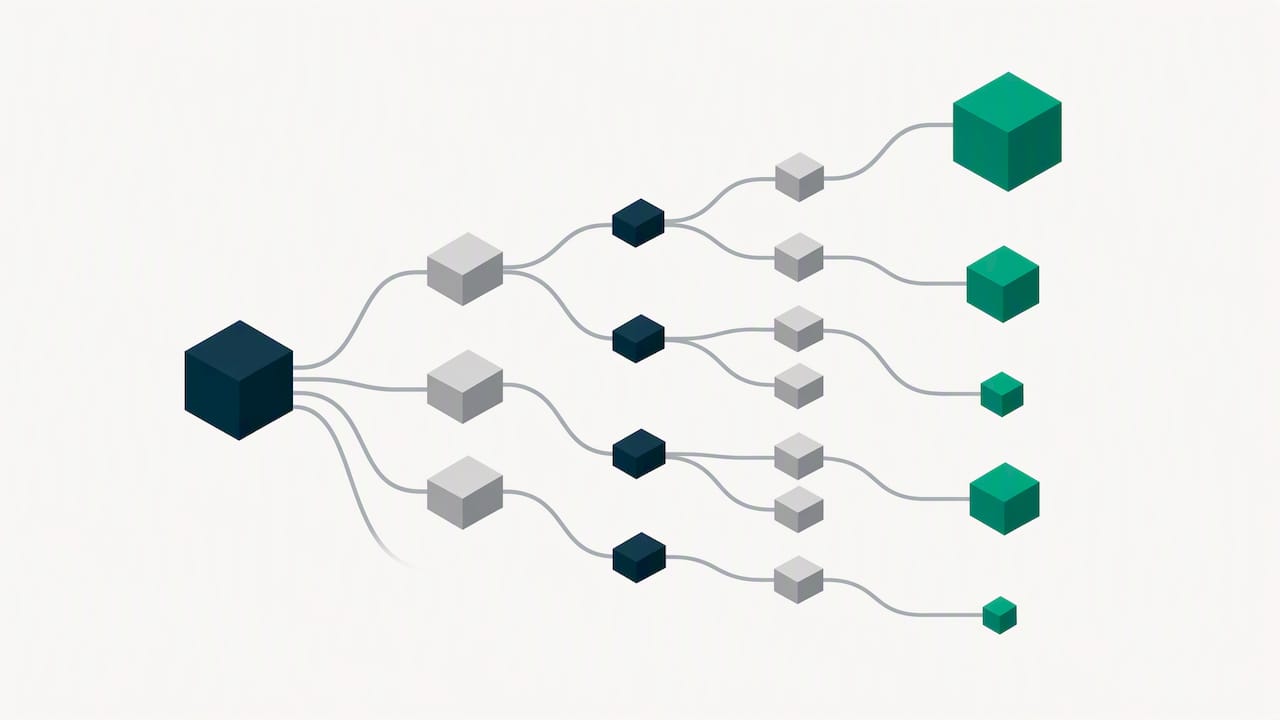
Koneoppimismallit ja AI-haastatteluraportit tuovat lisäarvoa erityisesti silloin, kun dataa on paljon ja signaalit ovat monimutkaisia. Tutkimus AI-haastattelukokeista osoittaa, että strukturoidut AI-haastattelut voivat nostaa läpäisyprosentteja merkittävästi tietyissä kokeissa, erityisesti juniorirooleissa, joissa ansioluettelot ovat niukkoja tai epätasaisia.
Mallityyppien valinnassa punnitaan tarkkuutta läpinäkyvyyttä ja ylläpidettävyyttä vastaan:
Tilastolliset perusmallit: läpinäkyviä, nopeita ottaa käyttöön, mutta karkeampia epävarmuuden kuvauksessa.
Monte Carlo: hyvä epävarmuuden mallinnuksessa, vaatii laadukasta vaiheittaista dataa.
Koneoppiminen: tarkin suurilla datamäärillä, mutta vaatii eniten ylläpitoa ja selitettävyystyötä.
Käytännön implementaatio: vaiheittainen opas datasta tuotokseen
Ennustemallin vieminen tuotantoon etenee järkevimmin vaiheittain, ei kertarysäyksellä koko organisaatiota kattavana projektina.
Aseta tavoite ja valitse KPI:t. Päätä, ennustetaanko täyttöaikaa, konversioita vai kapasiteettitarvetta tietylle roolityypille.
Auditoi data ja rakenna integraatiot. Yhdistä ATS- ja CRM-data ETL- tai ELT-putkella ja varmista kenttien yhtenäisyys.
Rakenna prototyyppi rajatulla segmentillä. Testaa mallia yhdellä roolityypillä tai yksiköllä ennen laajennusta.
Backtestaa historiadatalla. Vertaa mallin ennusteita toteutuneisiin lukuihin ja mittaa poikkeama.
Automatisoi ja monitoroi. Rakenna säännöllinen raportointi ja aseta hälytykset, kun ennuste poikkeaa merkittävästi toteumasta.
CIPD:n suositus korostaa, että hyvä ennustusprojekti alkaa yhdestä liiketoiminnallisesta käyttötapauksesta, ei koko organisaation kattavalla pilotilla. Tämä nopeuttaa oppimista ja näyttää ROI:n jo ensimmäisen vaiheen jälkeen.
Prototyyppivaiheessa kannattaa käyttää testidataa, joka on puhdistettu duplikaateista ja jossa aikaleimat ovat yhtenäisiä. Backtesting paljastaa nopeasti, toimiiko malli paremmin tietyillä segmenteillä kuin toisilla, mikä auttaa päättämään laajennusjärjestyksen.
Jatkuva parantaminen vaatii, että mallia päivitetään säännöllisesti uudella datalla ja että sen tarkkuutta seurataan ajan myötä. Ilman tätä mallin ennustekyky rapautuu, kun rekrytointiprosessi, markkinatilanne tai organisaation rakenne muuttuu.
Ammattilaisen vinkki: Dokumentoi jokainen mallin versio ja sen kouluttamiseen käytetty data: se helpottaa sekä virheiden jäljittämistä että myöhempää auditointia.
Katso myös käytännön ohjeet rekrytointiprojektien hallinnasta, kun integroit ennustemallia osaksi päivittäistä prosessia.
Riskit, sääntely ja eettinen hallinta: EU AI Act ja GDPR käytännössä
Rekrytoinnissa käytettävät ennustus- ja arviointijärjestelmät eivät ole sääntelyn ulkopuolella. EU:n AI Actin Annex III luokittelee rekrytoinnissa käytettävät arvioivat järjestelmät lähtökohtaisesti korkean riskin järjestelmiksi, mikä tarkoittaa tiukempia vaatimuksia läpinäkyvyydelle ja auditoitavuudelle.
Käytännön governance-toimet, jotka ennustusjärjestelmän ympärille kannattaa rakentaa:
Dokumentoi mallin logiikka, koulutusdata ja päätöksentekoperusteet selkeästi.
Testaa mallia säännöllisesti vinouman varalta eri hakijaryhmien välillä.
Säilytä ihmisen tekemä lopullinen päätöksenteko kriittisissä vaiheissa.
Tee vaikutustenarviointi (DPIA) ennen järjestelmän käyttöönottoa, kun henkilötietoja käsitellään laajasti.
GDPR-näkökulmasta ennustusjärjestelmä tarvitsee selkeän suostumuksen tietojen käsittelyyn, tietojen minimoinnin periaatteen noudattamisen ja mahdollisuuden anonymisoida arkaluonteiset tiedot tarvittaessa. Täydellinen kirjausketju, joka osoittaa kuka käsitteli mitä tietoa ja milloin, on sekä GDPR-vaatimus että käytännön suoja mahdollisissa kiistatilanteissa.
Vaatimus | Mitä se tarkoittaa käytännössä |
|---|---|
Läpinäkyvyys (AI Act) | Mallin logiikka ja päätösperusteet dokumentoitu |
Auditoitavuus (AI Act) | Jokainen päätös jäljitettävissä jälkikäteen |
Tietojen minimointi (GDPR) | Vain tarpeellinen data kerätään ja säilytetään |
Suostumus (GDPR) | Kandidaatilta pyydetty ja kirjattu lupa käsittelyyn |
Näiden käytäntöjen laiminlyönti ei ole pelkkä juridinen riski: se heikentää myös mallin luotettavuutta, koska dokumentoimaton ja auditoimaton järjestelmä on vaikea korjata, kun se alkaa tuottaa vääristyneitä ennusteita.
Käytännön esimerkki: näin integroitu alusta auttaa ennustamisessa
Yksi ennustamisen suurimmista käytännön esteistä on datan hajanaisuus: ATS, CRM ja taulukkolaskenta elävät usein erillään, eikä kukaan näe koko putkea yhdellä silmäyksellä. Tähän ongelmaan rakennamme Recruitify-alustaa, jossa ATS, myynnin CRM ja henkilöstövuokrauksen hallintamoduuli toimivat samassa järjestelmässä.
Ennustamisen kannalta erityisen hyödyllisiä ovat seuraavat ominaisuudet:
Contextual Matching AI & Scoring tuottaa prosentuaalisen sopivuusarvion jokaiselle hakemukselle, mikä antaa ennustemallille valmiiksi strukturoitua laatudataa pelkkien raakalukujen sijaan.
AI CV Parser rakentaa strukturoidun kandidaattiprofiilin kolmessa sekunnissa ja tunnistaa duplikaatit automaattisesti, mikä korjaa suoraan yhden yleisimmistä datan laatuongelmista.
GDPR-suostumusten hallintamoduuli tuottaa täydellisen kirjausketjun jokaisesta tietueesta, mikä tukee sekä AI Actin että GDPR:n auditointivaatimuksia.
Kun ATS- ja CRM-data elävät samassa järjestelmässä, vaiheiden väliset konversiot ja pipeline velocity ovat valmiiksi laskettavissa ilman erillistä integraatioprojektia. Tämä lyhentää merkittävästi aikaa, joka muuten kuluisi datan yhdistämiseen ennen kuin ensimmäistäkään ennustetta voi tuottaa.
Pilotti kannattaa aloittaa rajaamalla yksi roolityyppi tai segmentti, yhdistämällä sen data alustalle ja asettamalla selkeät KPI:t, kuten täyttöaika ja konversioaste, joita seurataan ensimmäisten kuukausien ajan.
Toimialanäkökulma: miksi siirtyä ennakoivaan rekrytointiin nyt
Ennakoiva rekrytointi ei ole enää vain suurten konsernien etuoikeus. Data-integraatioiden hinta on laskenut, ja valmiit AI-moduulit tekevät mallintamisesta saavutettavaa myös pienemmille rekrytointitiimeille. Silti moni organisaatio jää kuvailevan analytiikan tasolle, koska ensimmäinen askel tuntuu suuremmalta kuin se todellisuudessa on.
Järkevin prioriteetti on aloittaa yhdestä mittarista, esimerkiksi vaiheiden välisestä konversiosta yhdessä roolityypissä, ei koko putken mallintamisesta kerralla. Lyhyellä aikavälillä onnistumista mitataan sillä, paraniko ennusteen osumatarkkuus edelliseen kvartaaliin verrattuna. Keskipitkällä aikavälillä oikea mittari on se, vähenikö hätäpohjaisten rekrytointipäätösten määrä.
Suurin virhe ei ole väärän mallin valinta, vaan se, että dataa ei koskaan saada riittävän siistiksi mallinnusta varten.
- Recruitify Team
Miten Recruitify.ai voi nopeuttaa rekrytointiputken ennustamista
Kun ATS ja CRM ovat erillisiä järjestelmiä, suurin osa ennustusprojektin ajasta kuluu datan yhdistämiseen eikä itse mallintamiseen. Recruitify-alustalla tämä työ on tehty valmiiksi: ATS, CRM ja henkilöstövuokrauksen hallinta toimivat yhdessä järjestelmässä, jolloin vaiheiden konversiot ja pipeline velocity ovat laskettavissa ilman erillistä integraatioprojektia.
Ennustamisprojektiin sopivat erityisesti:
Contextual Matching AI & Scoring, joka tuottaa strukturoitua sopivuusdataa mallin pohjaksi.
AI CV Parser, joka puhdistaa ja yhtenäistää kandidaattidatan automaattisesti.
GDPR-suostumusten hallintamoduuli, joka tuottaa auditointiin tarvittavan kirjausketjun valmiina.
Pilotti kannattaa rakentaa rajatulle segmentille: liitämme olemassa olevan datasi alustalle, määrittelemme yhdessä seurattavat KPI:t ja arvioimme tuloksia muutaman kuukauden jaksolla ennen laajempaa käyttöönottoa. Tutustu hinnoitteluun ja valitse tiimisi kokoon sopiva paketti.
Usein kysytyt kysymykset
Mitä eroa on kuvailevalla ja ennustavalla rekrytointianalytiikalla?
Kuvaileva analytiikka kertoo, mitä rekrytointiprosessissa on jo tapahtunut, kun taas ennustava analytiikka arvioi, mitä todennäköisesti tapahtuu seuraavaksi nykyisten trendien perusteella. CIPD:n viitekehys lisää näiden rinnalle vielä ohjeistavan tason, joka suosittelee konkreettisia toimia.
Kuinka paljon dataa tarvitaan luotettavaan ennustemalliin?
Tarvittava datamäärä riippuu valitusta menetelmästä: yksinkertaiset tilastolliset mallit toimivat kohtuullisellakin historiadatalla, kun taas koneoppimismallit vaativat enemmän havaintoja ollakseen luotettavia. Kannattaa aloittaa yhdestä rajatusta segmentistä, jotta datan riittävyys voidaan arvioida nopeasti.
Vaikuttaako EU:n AI Act rekrytoinnin ennustusjärjestelmiin?
Kyllä. AI Actin Annex III luokittelee rekrytoinnissa käytettävät arvioivat järjestelmät lähtökohtaisesti korkean riskin järjestelmiksi, mikä edellyttää läpinäkyvyyttä, dokumentaatiota ja auditoitavuutta.
Voiko Monte Carlo -simulaatiota käyttää pienellä datamäärällä?
Monte Carlo -simulaatio toimii parhaiten, kun käytettävissä on hyvä vaiheittainen konversiodata. Ilman sitä simulointi tuottaa laajoja epävarmuusalueita, jolloin sen käytännön hyöty jää vähäiseksi verrattuna yksinkertaisempiin malleihin.
Mitä Recruitify-paketit maksavat ennustamisprojektin pilotointiin?
Starter-paketti alkaa 52 eurosta kuukaudessa käyttäjää kohden ja Agency-paketti 64 eurosta kuukaudessa käyttäjää kohden. Enterprise-paketin hinta on saatavilla erikseen pyynnöstä, katso tarkemmat tiedot hinnoittelusivulta.
Lähteet
Suositukset
Päivitykset ja uutuudet
Pysy ajan tasalla uusimpien innovaatioiden, ominaisuuksien ja vinkkien kanssa koskien Recruitify-sovellusta!
Antaessasi sähköpostiosoitteesi uutiskirjeen tilaamisen yhteydessä suostut sen käsittelyyn markkinointitietojen lähettämiseksi koskien Administraattorin tuotteita ja palveluita. Henkilötietojesi käsittelijä yllä olevaan tarkoitukseen on Recruitify Sp. z o.o., jonka päätoimipaikka on Varsovassa (KRS 0000709889). Lisätietoja henkilötietojen käsittelyn periaatteista ja niihin liittyvien henkilöiden oikeuksista löydät asiakirjasta Tietosuojakäytäntö.

Päivitetty:
Rekrytointiputken ennustaminen: näin ennakoit tarpeet ajoissa
Rekrytointiprosessi
Recruitify-tiimi
Rekrytointiputken ennustaminen tarkoittaa, että mittaamme vaiheiden välisiä konversioita ja kapasiteettia ennen kuin täyttötarve muuttuu akuutiksi ongelmaksi. Se vähentää hätäpohjaista rekrytointia ja parantaa täyttöasteita, kun päätökset perustuvat dataan arvailun sijaan. Nopein käytännön alku on yksinkertainen tilastollinen malli, joka rakennetaan ATS- ja CRM-datan pohjalta, ja jota voi myöhemmin laajentaa koneoppimiseen.
Lyhyesti:
Ennustava rekrytointiputki vaatii tarkkaa datan keräämistä ja laadun varmistamista, erityisesti vaiheiden välisissä konversioissa ja aikaleimoissa.
Menetelmät kuten tilastolliset mallit ja Monte Carlo -simulaatiot sopivat paremmin vakaaseen dataan, mutta koneoppiminen vaatii suurempia datamääriä ja ylläpitoa.
Pilotin kannattaa aloittaa yhdestä segmentistä ja käyttää testausta sekä backtestausta mallin luotettavuuden arvioimiseksi ennen laajentamista.
EU:n AI Act ja GDPR asettavat ennustusjärjestelmille tiukkoja läpinäkyvyys- ja auditoimivaatimuksia, jotka edellyttävät selkeää dokumentaatiota ja suostumusprosessia.
Ennustemallien toteutus sujuu nopeammin, kun järjestelmät kuten ATS ja CRM ovat integroitu samoihin alustoihin, mikä vähentää datayhdistämiseen kuluvaa aikaa.
RecruitifyEnnakoi rekrytointitarpeet yhdestä näkymästäRecruitify yhdistää ATS:n, myynnin CRM:n ja analytiikan, jotta rekrytointiputken tiedot pysyvät samassa toimintaympäristössä.Tutustu Recruitifyhin
Sisällysluettelo
Mitä tarkoittaa rekrytointiputken ennustaminen ja milloin sitä tarvitaan
Keskeiset mittarit ja datalähteet, joita ennustukseen tarvitaan
Menetelmät: tilastollisista malleista Monte Carloon ja koneoppimiseen
Käytännön implementaatio: vaiheittainen opas datasta tuotokseen
Riskit, sääntely ja eettinen hallinta: EU AI Act ja GDPR käytännössä
Käytännön esimerkki: näin integroitu alusta auttaa ennustamisessa
Toimialanäkökulma: miksi siirtyä ennakoivaan rekrytointiin nyt
Miten Recruitify.ai voi nopeuttaa rekrytointiputken ennustamista
Usein kysytyt kysymykset
Lähteet
Mitä tarkoittaa rekrytointiputken ennustaminen ja milloin sitä tarvitaan
Rekrytointiputken ennustaminen tarkoittaa menneen datan ja nykyisten signaalien käyttöä tulevien täyttötarpeiden, konversioiden ja aikataulujen arvioimiseksi. Käytännössä kyse on kolmesta eri analytiikan tasosta, jotka CIPD:n people analytics -viitekehys erottaa toisistaan selvästi.
Kuvaileva analytiikka kertoo, mitä on tapahtunut: kuinka monta hakemusta vastaanotimme viime kuussa tai mikä oli keskimääräinen rekrytointiaika. Ennustava analytiikka menee pidemmälle ja arvioi, mitä todennäköisesti tapahtuu seuraavaksi nykyisten trendien perusteella. Ohjeistava analytiikka taas suosittelee konkreettisia toimia: montako uutta kandidaattia putkeen tarvitaan, jotta tavoiteltu täyttömäärä toteutuu.
Ennustaminen tuo eniten arvoa silloin, kun rekrytointivolyymi on suuri, organisaatio kasvaa nopeasti tai henkilöstön vaihtuvuus on korkea. Pienessä, tasaisessa rekrytointivirrassa yksinkertainen seuranta usein riittää.
Tyypillisiä tilanteita, joissa ennustaminen kannattaa:
Kausivaihtelu vaikuttaa hakijamääriin ja täyttöaikoihin merkittävästi.
Useita rooleja täytetään samanaikaisesti rajallisilla rekrytointiresursseilla.
Liiketoiminta kasvaa nopeasti ja henkilöstötarve muuttuu kuukausittain.
Vaihtuvuus tietyssä roolissa tai yksikössä on toistuvasti korkea.
CIPD:n resursointiraportit osoittavat, että moni organisaatio kerää rekrytointidataa, mutta vain harva laskee prosessiensa tuottoa tai käyttää strukturoitua ennustamista systemaattisesti.
Keskeiset mittarit ja datalähteet, joita ennustukseen tarvitaan
Toimiva ennustemalli tarvitsee tarkasti määritellyt mittarit ja luotettavan datapohjan. Ilman niitä paras algoritmikaan ei tuota käyttökelpoisia tuloksia.
Kriittisimmät mittarit ovat seuraavat:
Pipeline velocity, eli nopeus, jolla kandidaatit etenevät vaiheesta toiseen.
Vaiheiden väliset konversioprosentit, esimerkiksi hakemuksesta haastatteluun ja haastattelusta tarjoukseen.
Time-to-hire, kokonaisaika ensimmäisestä kontaktista allekirjoitettuun sopimukseen.
Lead-to-hire-suhde, joka kertoo kuinka suuri osa liideistä päätyy palkkaukseen.
Lähteen laatu (source quality), eli mistä kanavista tulevat kandidaatit etenevät parhaiten.
Näitä tietoja kerätään useasta järjestelmästä: ATS tallentaa hakemusten ja vaiheiden historian, CRM kertoo liidien ja asiakassuhteiden tilan, HRIS tuo organisaatiorakenteen ja henkilöstötiedot, ja arviointijärjestelmät tuottavat laatua kuvaavaa dataa haastatteluista. Ulkoiset indikaattorit, kuten toimialan työmarkkinatilanne, täydentävät kuvaa mutta harvoin korvaavat sisäistä dataa.
Datan laatu on usein suurin käytännön este. Duplikaattiprofiilit vääristävät konversiolaskelmia, puuttuvat tai epäjohdonmukaiset aikaleimat tekevät time-to-hire-mittauksesta epäluotettavan, ja standardoimattomat kentät (esimerkiksi vapaamuotoiset tekstikentät roolin sijaan) vaikeuttavat vaiheiden vertailua eri tiimien välillä. Näihin ongelmiin kannattaa vastata ennen mallinnuksen aloittamista: yhtenäistä kenttästandardit, poista duplikaatit automaattisesti ja varmista, että jokainen vaihemuutos kirjataan aikaleimalla.
Ammattilaisen vinkki: Aloita yhdestä putken segmentistä, esimerkiksi yhdestä roolityypistä, ennen koko organisaation kattavaa mittaristoa: se paljastaa datan puutteet nopeasti ja halvalla.
Menetelmät: tilastollisista malleista Monte Carloon ja koneoppimiseen
Ennustusmenetelmät jakautuvat karkeasti kolmeen ryhmään, joilla jokaisella on oma datavaatimuksensa ja käyttötarkoituksensa.
Yksinkertaiset tilastolliset mallit, kuten liukuvat keskiarvot tai perinteiset aikasarjamallit, soveltuvat hyvin silloin, kun historiadataa on kohtuullisesti ja prosessi on suhteellisen vakaa. Ne ovat läpinäkyviä ja helposti selitettäviä, mikä on etu sekä johdolle että auditoinneille.
Monte Carlo -simulaatio tuo mukaan epävarmuuden kvantifioinnin: sen sijaan, että ennustaisimme yhden luvun, se tuottaa todennäköisyysjakauman mahdollisista lopputuloksista satoja tai tuhansia kertoja toistetun satunnaisotannan avulla. Aalto-yliopiston tapaustutkimus osoittaa menetelmän hyödyllisyyden myyntiprosessin ennustamisessa, ja samaa logiikkaa voi soveltaa rekrytointiputkeen silloin, kun vaiheittainen konversiodata on riittävän kattavaa. Ilman hyvää vaiheittaista dataa simulointi tuottaa kuitenkin hyvin laajoja epävarmuusalueita, jolloin sen käytännön hyöty jää vähäiseksi.
Koneoppimismallit ja AI-haastatteluraportit tuovat lisäarvoa erityisesti silloin, kun dataa on paljon ja signaalit ovat monimutkaisia. Tutkimus AI-haastattelukokeista osoittaa, että strukturoidut AI-haastattelut voivat nostaa läpäisyprosentteja merkittävästi tietyissä kokeissa, erityisesti juniorirooleissa, joissa ansioluettelot ovat niukkoja tai epätasaisia.
Mallityyppien valinnassa punnitaan tarkkuutta läpinäkyvyyttä ja ylläpidettävyyttä vastaan:
Tilastolliset perusmallit: läpinäkyviä, nopeita ottaa käyttöön, mutta karkeampia epävarmuuden kuvauksessa.
Monte Carlo: hyvä epävarmuuden mallinnuksessa, vaatii laadukasta vaiheittaista dataa.
Koneoppiminen: tarkin suurilla datamäärillä, mutta vaatii eniten ylläpitoa ja selitettävyystyötä.
Käytännön implementaatio: vaiheittainen opas datasta tuotokseen
Ennustemallin vieminen tuotantoon etenee järkevimmin vaiheittain, ei kertarysäyksellä koko organisaatiota kattavana projektina.
Aseta tavoite ja valitse KPI:t. Päätä, ennustetaanko täyttöaikaa, konversioita vai kapasiteettitarvetta tietylle roolityypille.
Auditoi data ja rakenna integraatiot. Yhdistä ATS- ja CRM-data ETL- tai ELT-putkella ja varmista kenttien yhtenäisyys.
Rakenna prototyyppi rajatulla segmentillä. Testaa mallia yhdellä roolityypillä tai yksiköllä ennen laajennusta.
Backtestaa historiadatalla. Vertaa mallin ennusteita toteutuneisiin lukuihin ja mittaa poikkeama.
Automatisoi ja monitoroi. Rakenna säännöllinen raportointi ja aseta hälytykset, kun ennuste poikkeaa merkittävästi toteumasta.
CIPD:n suositus korostaa, että hyvä ennustusprojekti alkaa yhdestä liiketoiminnallisesta käyttötapauksesta, ei koko organisaation kattavalla pilotilla. Tämä nopeuttaa oppimista ja näyttää ROI:n jo ensimmäisen vaiheen jälkeen.
Prototyyppivaiheessa kannattaa käyttää testidataa, joka on puhdistettu duplikaateista ja jossa aikaleimat ovat yhtenäisiä. Backtesting paljastaa nopeasti, toimiiko malli paremmin tietyillä segmenteillä kuin toisilla, mikä auttaa päättämään laajennusjärjestyksen.
Jatkuva parantaminen vaatii, että mallia päivitetään säännöllisesti uudella datalla ja että sen tarkkuutta seurataan ajan myötä. Ilman tätä mallin ennustekyky rapautuu, kun rekrytointiprosessi, markkinatilanne tai organisaation rakenne muuttuu.
Ammattilaisen vinkki: Dokumentoi jokainen mallin versio ja sen kouluttamiseen käytetty data: se helpottaa sekä virheiden jäljittämistä että myöhempää auditointia.
Katso myös käytännön ohjeet rekrytointiprojektien hallinnasta, kun integroit ennustemallia osaksi päivittäistä prosessia.
Riskit, sääntely ja eettinen hallinta: EU AI Act ja GDPR käytännössä
Rekrytoinnissa käytettävät ennustus- ja arviointijärjestelmät eivät ole sääntelyn ulkopuolella. EU:n AI Actin Annex III luokittelee rekrytoinnissa käytettävät arvioivat järjestelmät lähtökohtaisesti korkean riskin järjestelmiksi, mikä tarkoittaa tiukempia vaatimuksia läpinäkyvyydelle ja auditoitavuudelle.
Käytännön governance-toimet, jotka ennustusjärjestelmän ympärille kannattaa rakentaa:
Dokumentoi mallin logiikka, koulutusdata ja päätöksentekoperusteet selkeästi.
Testaa mallia säännöllisesti vinouman varalta eri hakijaryhmien välillä.
Säilytä ihmisen tekemä lopullinen päätöksenteko kriittisissä vaiheissa.
Tee vaikutustenarviointi (DPIA) ennen järjestelmän käyttöönottoa, kun henkilötietoja käsitellään laajasti.
GDPR-näkökulmasta ennustusjärjestelmä tarvitsee selkeän suostumuksen tietojen käsittelyyn, tietojen minimoinnin periaatteen noudattamisen ja mahdollisuuden anonymisoida arkaluonteiset tiedot tarvittaessa. Täydellinen kirjausketju, joka osoittaa kuka käsitteli mitä tietoa ja milloin, on sekä GDPR-vaatimus että käytännön suoja mahdollisissa kiistatilanteissa.
Vaatimus | Mitä se tarkoittaa käytännössä |
|---|---|
Läpinäkyvyys (AI Act) | Mallin logiikka ja päätösperusteet dokumentoitu |
Auditoitavuus (AI Act) | Jokainen päätös jäljitettävissä jälkikäteen |
Tietojen minimointi (GDPR) | Vain tarpeellinen data kerätään ja säilytetään |
Suostumus (GDPR) | Kandidaatilta pyydetty ja kirjattu lupa käsittelyyn |
Näiden käytäntöjen laiminlyönti ei ole pelkkä juridinen riski: se heikentää myös mallin luotettavuutta, koska dokumentoimaton ja auditoimaton järjestelmä on vaikea korjata, kun se alkaa tuottaa vääristyneitä ennusteita.
Käytännön esimerkki: näin integroitu alusta auttaa ennustamisessa
Yksi ennustamisen suurimmista käytännön esteistä on datan hajanaisuus: ATS, CRM ja taulukkolaskenta elävät usein erillään, eikä kukaan näe koko putkea yhdellä silmäyksellä. Tähän ongelmaan rakennamme Recruitify-alustaa, jossa ATS, myynnin CRM ja henkilöstövuokrauksen hallintamoduuli toimivat samassa järjestelmässä.
Ennustamisen kannalta erityisen hyödyllisiä ovat seuraavat ominaisuudet:
Contextual Matching AI & Scoring tuottaa prosentuaalisen sopivuusarvion jokaiselle hakemukselle, mikä antaa ennustemallille valmiiksi strukturoitua laatudataa pelkkien raakalukujen sijaan.
AI CV Parser rakentaa strukturoidun kandidaattiprofiilin kolmessa sekunnissa ja tunnistaa duplikaatit automaattisesti, mikä korjaa suoraan yhden yleisimmistä datan laatuongelmista.
GDPR-suostumusten hallintamoduuli tuottaa täydellisen kirjausketjun jokaisesta tietueesta, mikä tukee sekä AI Actin että GDPR:n auditointivaatimuksia.
Kun ATS- ja CRM-data elävät samassa järjestelmässä, vaiheiden väliset konversiot ja pipeline velocity ovat valmiiksi laskettavissa ilman erillistä integraatioprojektia. Tämä lyhentää merkittävästi aikaa, joka muuten kuluisi datan yhdistämiseen ennen kuin ensimmäistäkään ennustetta voi tuottaa.
Pilotti kannattaa aloittaa rajaamalla yksi roolityyppi tai segmentti, yhdistämällä sen data alustalle ja asettamalla selkeät KPI:t, kuten täyttöaika ja konversioaste, joita seurataan ensimmäisten kuukausien ajan.
Toimialanäkökulma: miksi siirtyä ennakoivaan rekrytointiin nyt
Ennakoiva rekrytointi ei ole enää vain suurten konsernien etuoikeus. Data-integraatioiden hinta on laskenut, ja valmiit AI-moduulit tekevät mallintamisesta saavutettavaa myös pienemmille rekrytointitiimeille. Silti moni organisaatio jää kuvailevan analytiikan tasolle, koska ensimmäinen askel tuntuu suuremmalta kuin se todellisuudessa on.
Järkevin prioriteetti on aloittaa yhdestä mittarista, esimerkiksi vaiheiden välisestä konversiosta yhdessä roolityypissä, ei koko putken mallintamisesta kerralla. Lyhyellä aikavälillä onnistumista mitataan sillä, paraniko ennusteen osumatarkkuus edelliseen kvartaaliin verrattuna. Keskipitkällä aikavälillä oikea mittari on se, vähenikö hätäpohjaisten rekrytointipäätösten määrä.
Suurin virhe ei ole väärän mallin valinta, vaan se, että dataa ei koskaan saada riittävän siistiksi mallinnusta varten.
- Recruitify Team
Miten Recruitify.ai voi nopeuttaa rekrytointiputken ennustamista
Kun ATS ja CRM ovat erillisiä järjestelmiä, suurin osa ennustusprojektin ajasta kuluu datan yhdistämiseen eikä itse mallintamiseen. Recruitify-alustalla tämä työ on tehty valmiiksi: ATS, CRM ja henkilöstövuokrauksen hallinta toimivat yhdessä järjestelmässä, jolloin vaiheiden konversiot ja pipeline velocity ovat laskettavissa ilman erillistä integraatioprojektia.
Ennustamisprojektiin sopivat erityisesti:
Contextual Matching AI & Scoring, joka tuottaa strukturoitua sopivuusdataa mallin pohjaksi.
AI CV Parser, joka puhdistaa ja yhtenäistää kandidaattidatan automaattisesti.
GDPR-suostumusten hallintamoduuli, joka tuottaa auditointiin tarvittavan kirjausketjun valmiina.
Pilotti kannattaa rakentaa rajatulle segmentille: liitämme olemassa olevan datasi alustalle, määrittelemme yhdessä seurattavat KPI:t ja arvioimme tuloksia muutaman kuukauden jaksolla ennen laajempaa käyttöönottoa. Tutustu hinnoitteluun ja valitse tiimisi kokoon sopiva paketti.
Usein kysytyt kysymykset
Mitä eroa on kuvailevalla ja ennustavalla rekrytointianalytiikalla?
Kuvaileva analytiikka kertoo, mitä rekrytointiprosessissa on jo tapahtunut, kun taas ennustava analytiikka arvioi, mitä todennäköisesti tapahtuu seuraavaksi nykyisten trendien perusteella. CIPD:n viitekehys lisää näiden rinnalle vielä ohjeistavan tason, joka suosittelee konkreettisia toimia.
Kuinka paljon dataa tarvitaan luotettavaan ennustemalliin?
Tarvittava datamäärä riippuu valitusta menetelmästä: yksinkertaiset tilastolliset mallit toimivat kohtuullisellakin historiadatalla, kun taas koneoppimismallit vaativat enemmän havaintoja ollakseen luotettavia. Kannattaa aloittaa yhdestä rajatusta segmentistä, jotta datan riittävyys voidaan arvioida nopeasti.
Vaikuttaako EU:n AI Act rekrytoinnin ennustusjärjestelmiin?
Kyllä. AI Actin Annex III luokittelee rekrytoinnissa käytettävät arvioivat järjestelmät lähtökohtaisesti korkean riskin järjestelmiksi, mikä edellyttää läpinäkyvyyttä, dokumentaatiota ja auditoitavuutta.
Voiko Monte Carlo -simulaatiota käyttää pienellä datamäärällä?
Monte Carlo -simulaatio toimii parhaiten, kun käytettävissä on hyvä vaiheittainen konversiodata. Ilman sitä simulointi tuottaa laajoja epävarmuusalueita, jolloin sen käytännön hyöty jää vähäiseksi verrattuna yksinkertaisempiin malleihin.
Mitä Recruitify-paketit maksavat ennustamisprojektin pilotointiin?
Starter-paketti alkaa 52 eurosta kuukaudessa käyttäjää kohden ja Agency-paketti 64 eurosta kuukaudessa käyttäjää kohden. Enterprise-paketin hinta on saatavilla erikseen pyynnöstä, katso tarkemmat tiedot hinnoittelusivulta.
Lähteet
Suositukset
Päivitykset ja uutuudet
Pysy ajan tasalla uusimpien innovaatioiden, ominaisuuksien ja vinkkien kanssa koskien Recruitify-sovellusta!
Antaessasi sähköpostiosoitteesi uutiskirjeen tilaamisen yhteydessä suostut sen käsittelyyn markkinointitietojen lähettämiseksi koskien Administraattorin tuotteita ja palveluita. Henkilötietojesi käsittelijä yllä olevaan tarkoitukseen on Recruitify Sp. z o.o., jonka päätoimipaikka on Varsovassa (KRS 0000709889). Lisätietoja henkilötietojen käsittelyn periaatteista ja niihin liittyvien henkilöiden oikeuksista löydät asiakirjasta Tietosuojakäytäntö.
Tutustu myös
Rekrytointiprosessi
Skill tagging rekrytointi: miten osaamistunnisteet nopeuttavat ATS:ää
Osaamistunnisteet tehostavat rekrytointia: löydä sopivat kandidaatit taitojen perusteella, älä vain CV:n avainsanojen avulla, ja kokoa ehdokaslista nopeammin.
10.10.2026
Näytä lisää

Uutiset
Projektiresursoinnin rekrytointi: mitä järjestelmän pitää ratkaista
Tutustu, miten projektiresursoinnin rekrytointi nopeutuu, kun hakijanseuranta, asiakkuudenhallinta ja osaajapooli yhdistyvät automaatioon ja...
9.10.2026
Näytä lisää
Rekrytointiprosessi
Rekrytoinnin konversiot: mitä mitata ensin ja miksi
Mittaa rekrytoinnin konversioita: aloita tarjoushyväksyntäprosentista, paljasta hukkaa, säästä budjettia ja tehosta palkkausta.
7.10.2026
Näytä lisää
Rekrytointiprosessi
Skill tagging rekrytointi: miten osaamistunnisteet nopeuttavat ATS:ää
Osaamistunnisteet tehostavat rekrytointia: löydä sopivat kandidaatit taitojen perusteella, älä vain CV:n avainsanojen avulla, ja kokoa ehdokaslista nopeammin.
10.10.2026
Näytä lisää
Uutiset
Projektiresursoinnin rekrytointi: mitä järjestelmän pitää ratkaista
Tutustu, miten projektiresursoinnin rekrytointi nopeutuu, kun hakijanseuranta, asiakkuudenhallinta ja osaajapooli yhdistyvät automaatioon ja...
9.10.2026
Näytä lisää