Aktualisiert am:
Semantisches Matching: Hybride Methoden und Bewertung für Job-Matching
Neuigkeiten

Recruitify Team
Semantisches Matching ordnet zwei Texte oder Konzepte nach Bedeutung und verbindet damit zum Beispiel Lebensläufe und Stellenanzeigen auch ohne gemeinsame Schlüsselwörter. Technisch stützt sich dieser Ansatz auf drei Bausteine: dichte Embeddings, Knowledge Graphs und hybride Architekturen, die beides kombinieren. Für die Praxis bedeutet das: Kandidatenprofile und Anforderungen lassen sich verknüpfen, selbst wenn Formulierungen stark voneinander abweichen.
Kurz gesagt:
Eine hybride Suche verbindet dichte Einbettungen, BM25 und Wissensgraphen: Sie findet Synonyme, erfasst seltene Fachbegriffe und zeigt nachvollziehbare Verbindungspfade zwischen den Konzepten.
Ein globaler Durchschnitt kann Schwächen bei mehrdeutigen Treffern verdecken; bewerten Sie deshalb Fälle nach geringer, mittlerer und hoher Bedeutungsnähe und berichten Sie Konfidenzintervalle je Gruppe.
Die Ergänzung feinabgestimmter Einbettungsmodelle durch Wissensgraphen senkte in einer Forschungsarbeit den RMSE bei eng verwandten Rollen und Fähigkeiten um rund 25 Prozent.
Bei großen Datenbeständen sollte die Suche zunächst mit Indizes zur näherungsweisen Nachbarsuche und BM25 Kandidaten sammeln; ein teures Sprachmodell bewertet anschließend nur die engere Auswahl.
Für die Personalauswahl in Europa empfiehlt sich, die Inferenz in der EU auszuführen oder Einbettungen lokal zu erzeugen, um Datenverarbeitung und Export einfacher zu regeln.
RecruitifyPassende Talente semantisch erkennenRecruitifys Contextual Matching AI bewertet Kandidatenprofile anhand von Projektanforderungen und erstellt Shortlists mit prozentualem Match-Score.Recruitify entdecken
Inhaltsverzeichnis
Definition und Abgrenzung zu STS und STR
Kernmethoden: Embeddings, Knowledge Graphs und Hybrid-Modelle
Bewertung und Metriken: warum stratifizierte Evaluation sinnvoll ist
Architektur-Pattern für Produktion: retrieve-then-rerank und Skalierung
Anwendungsbeispiel: Job- und Kandidatenmatching
Evidenz und Praxisbelege für erklärbares Matching
Ausblick: Forschungstrends und Prioritäten für Praktiker
Recruitify als DSGVO-gestützte Umsetzung semantischen Matchings
FAQ
Quellen
Definition und Abgrenzung zu STS und STR
Semantisches Matching bezeichnet, formal betrachtet, die Zuordnung zweier Objekte anhand ihres Bedeutungsgehalts statt anhand wörtlicher Übereinstimmung. Das National Institute of Standards and Technology definiert den Begriff als Nutzung kontextueller Attribute zur Interpretation digitaler Objekte, wobei semantische Verfahren tendenziell spezifischere, aber auch rechenintensivere Ergebnisse liefern als rein lexikalische Methoden.
Von zwei verwandten Konzepten muss man semantisches Matching klar abgrenzen:
Semantic Textual Similarity (STS): misst, wie ähnlich zwei Texte in Bedeutung und Formulierung sind.
Semantic Textual Relatedness (STR): erfasst einen breiteren Bezug zwischen Texten, auch wenn sie inhaltlich verschieden, aber thematisch verbunden sind.
Für das Matching von Jobtiteln etwa reicht reine Ähnlichkeit oft nicht aus: Ein „Senior Backend Engineer“ und ein „Lead Platform Developer“ sind sich textuell kaum ähnlich, stehen aber in enger Beziehung. Typische Inputs sind einzelne Sätze, Stellentitel oder Knoten in einem Graphen, je nachdem, welche Granularität die Anwendung verlangt.
Kernmethoden: Embeddings, Knowledge Graphs und Hybrid-Modelle
Dichte Embeddings bilden Wörter, Sätze oder ganze Dokumente als Vektoren in einem hochdimensionalen Raum ab. Modelle wie Sentence-BERT (SBERT) sind speziell darauf trainiert, semantisch ähnliche Sätze nah beieinander zu platzieren, sodass sich Nähe über Kosinus-Ähnlichkeit berechnen lässt. Anders als klassische Keyword-Suche erfasst dieser Ansatz auch Synonyme, Umschreibungen und implizite Zusammenhänge.
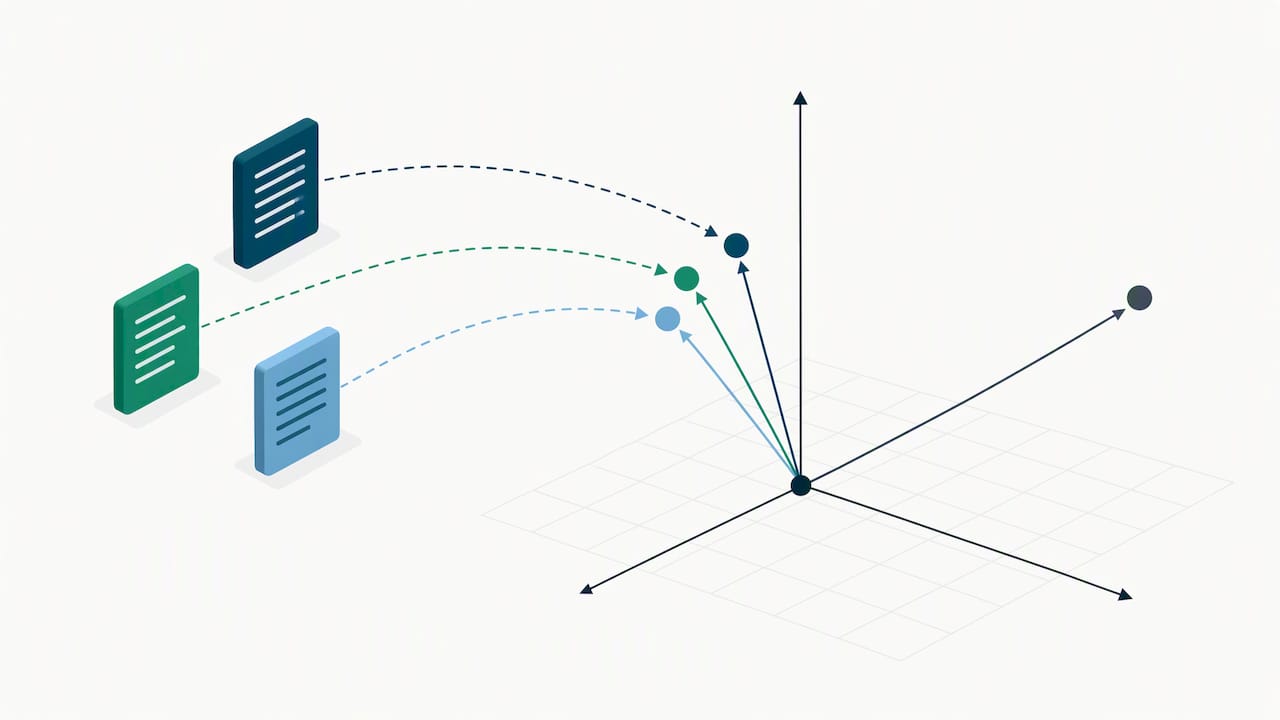
Knowledge Graphs ergänzen diese Vektorräume um explizite, strukturierte Relationen: Ein Skill wie „Kubernetes“ lässt sich dort formal mit „Container-Orchestrierung“ oder „DevOps“ verknüpfen. Dadurch entsteht Nachvollziehbarkeit, die reine Embedding-Scores nicht liefern: Man sieht, über welchen Pfad zwei Konzepte verbunden sind.
Hybrid-Designs kombinieren beide Welten mit einer dritten Komponente, der lexikalischen Suche über BM25. Ein typisches Setup sieht so aus:
Ein Embedding-Index liefert semantische Kandidaten jenseits exakter Wortübereinstimmung.
BM25 fängt exakte Begriffe und seltene Fachtermini zuverlässig ab.
Graph-Traversal liefert erklärbare, strukturierte Zusatzrelationen.
Fine-Tuning auf domänenspezifischen Daten verbessert die Trennschärfe solcher Modelle erheblich, oft über Contrastive Learning, bei dem das Modell lernt, ähnliche Paare näher und unähnliche Paare weiter auseinander zu platzieren.
Profi-Tipp: Trainieren Sie Embedding-Modelle mit domänenspezifischen Negativbeispielen, nicht nur mit zufälligen Paaren, denn das schärft die Trennung zwischen echten und oberflächlichen Ähnlichkeiten deutlich.
Bewertung und Metriken: warum stratifizierte Evaluation sinnvoll ist
Precision, Recall und F1-Score bilden die Basismetriken, mit denen sich Matching-Qualität grundsätzlich beurteilen lässt: Precision zeigt, wie viele gefundene Treffer tatsächlich relevant sind, Recall erfasst, wie viele der relevanten Treffer überhaupt gefunden wurden, und F1 verbindet beide zu einem Gesamtwert.
Ein globaler Durchschnittswert verschleiert jedoch oft entscheidende Schwächen. Ein Modell kann bei eindeutigen Fällen glänzen und bei schwierigen, mehrdeutigen Paaren deutlich schlechter abschneiden, ohne dass der Gesamtscore das zeigt. Genau deshalb empfiehlt sich eine stratifizierte Evaluation, die Testfälle nach dem Grad ihrer semantischen Beziehung aufteilt:
Fälle mit niedriger STR: kaum thematischer Bezug.
Fälle mit mittlerer STR: loser, aber erkennbarer Zusammenhang.
Fälle mit hoher STR: enge inhaltliche Nähe.
Die Integration von Knowledge Graphs in feingetunte SBERT-Modelle hat in Forschungsarbeiten zu erklärbarem Job-Titel-Matching den RMSE im hochrelevanten STR-Bereich um rund 25 Prozent reduziert. Diese Verbesserung zeigt sich gerade dort, wo Recruiting-Systeme am meisten auf Präzision angewiesen sind, nämlich bei eng verwandten Rollen und Skills. Für belastbares Reporting lohnt es sich, Konfidenzintervalle je Stratum auszuweisen statt nur einen einzigen Gesamtwert.
Architektur-Pattern für Produktion: retrieve-then-rerank und Skalierung
Für produktive Matching-Systeme hat sich ein zweistufiges Muster durchgesetzt, bekannt als retrieve-then-rerank. Der Ablauf gliedert sich typischerweise so:
Eine schnelle Retrieval-Phase holt mit Approximate-Nearest-Neighbor-Indizes (ANN) und BM25 eine breite Kandidatenmenge aus Millionen von Datensätzen.
Eine Graph-Abfrage reichert diese Kandidaten um strukturierte Relationen an, etwa Skill-Hierarchien oder Karrierepfade.
Ein Reranker, oft ein feingetuntes Transformer-Modell, bewertet die engere Kandidatenmenge präzise neu und liefert die finale Rangfolge.
Kosten spielen bei der Modellwahl eine erhebliche Rolle. Vergleichende Untersuchungen zeigen, dass Embedding-Pipelines für Similarity- und Klassifikationsaufgaben kosteneffizient bleiben, während große Sprachmodelle deutlich teurer ausfallen und sich vor allem für reasoning-intensive Retrieval-Schritte lohnen. Ein sinnvolles Muster trennt deshalb die Aufgaben: Embeddings übernehmen den schnellen, breiten Filter, ein LLM bewertet nur die verbleibende Shortlist.
Für Nachvollziehbarkeit kombiniert man deterministische Ähnlichkeits-Scores mit graphbasierten Pfaden, die zeigen, warum zwei Entitäten als verwandt gelten. Bei wachsendem Datenvolumen helfen approximative Indexstrukturen und Caching häufiger Anfragen, die Antwortzeiten stabil zu halten.
Anwendungsbeispiel: Job- und Kandidatenmatching
Jobtitel sind ein klassisches Beispiel für die Schwächen reiner Schlagwortsuche: „Data Engineer“, „Dateningenieur“ und „Analytics Engineer“ bezeichnen oft ähnliche, aber nicht identische Rollen, und eine einfache Keyword-Suche übersieht solche Übergänge regelmäßig.
Eine End-to-End-Pipeline für Kandidatenmatching durchläuft typischerweise folgende Schritte:
Ingestion: Lebensläufe und Stellenanzeigen werden strukturiert aufbereitet.
Embedding: Skills, Titel und Erfahrungen werden in Vektoren umgewandelt.
Graph-Anreicherung: Skill-Beziehungen und Karrierepfade ergänzen die Vektordaten.
Reranking: Eine finale Bewertung liefert eine erklärbare Rangfolge.
Demo-Deployments mit produktionsreifen Hybrid-Retrieval-Stacks zeigen, dass die Kombination aus BM25, dichten Embeddings und Graph-Traversal bessere Ranking-Ergebnisse liefert als rein lexikalische Ansätze, und gleichzeitig auditierbare Erklärungen ermöglicht. Für DSGVO-relevante Architekturentscheidungen empfiehlt sich dabei, Inferenz EU-seitig zu hosten oder Embeddings lokal zu erzeugen, wie unser Beitrag zu Compliance beim Einsatz von KI im Recruiting näher beschreibt.
Evidenz und Praxisbelege für erklärbares Matching
Mehrere Forschungsarbeiten stützen die hier beschriebenen Architekturentscheidungen mit konkreten Ergebnissen statt mit allgemeinen Behauptungen.
Die KG-Integration in feingetunte Embedding-Modelle verbessert messbar die Erklärbarkeit von Matches, weil getrennte Graphpfade nachvollziehbar bleiben.
Stratifizierte Evaluation deckt Modellschwächen auf, die globale Metriken verbergen, und erlaubt gezielte Modellwahl für High-STR-Anwendungsfälle wie HR.
Für europäische Kontexte empfehlen Praxisleitfäden zu DSGVO-konformer KI lokale Embeddings oder EU-gehostete Inferenzendpunkte, um Fragen zu Auftragsverarbeitung und Datenexport zu vereinfachen.
Die Integration von Knowledge Graphs reduzierte den RMSE im High-STR-Bereich in kontrollierten Experimenten um etwa ein Viertel, ein Hinweis darauf, dass strukturierte Relationen gerade bei eng verwandten Profilen einen messbaren Unterschied machen. Eine Contextual Matching AI bewertet Tech-Stacks im Kontext, nicht als isolierte Schlagwortliste, und ein AI CV Parser extrahiert strukturierte Profile aus verschiedensten Dateiformaten, während ein vollständiger GDPR-Audit-Trail jeden Verarbeitungsschritt dokumentiert.
Ausblick: Forschungstrends und Prioritäten für Praktiker
Die Integration von Knowledge Graphs in Embedding-basierte Systeme wird aus unserer Sicht weiter zunehmen, einfach weil Erklärbarkeit in regulierten Bereichen wie HR kein Nebenaspekt mehr ist, sondern eine Voraussetzung. Retrieve-then-rerank bleibt dabei das dominante Produktionsmuster, LLMs kommen gezielt dort zum Einsatz, wo reines Reasoning gefragt ist, nicht als Ersatz für effiziente Embedding-Pipelines. Wer jetzt plant, sollte auf modulare, auditierbare Architekturen setzen statt auf monolithische Blackboxes.
- Recruitify Team
Recruitify als DSGVO-gestützte Umsetzung semantischen Matchings
Die hier beschriebenen Prinzipien, hybride Retrieval-Architekturen, stratifizierte Bewertung und erklärbare Scores, lassen sich mit einer passenden Plattform direkt umsetzen, ohne dass Ihr Team ein eigenes Matching-System aufbauen muss. Eine Contextual Matching AI bewertet Tech-Stacks und Erfahrungen kontextuell und liefert fertige Shortlists mit einem prozentualen Match-Score statt einer bloßen Keyword-Trefferliste. Ein AI CV Parser extrahiert strukturierte Profile aus PDFs, DOCX-Dateien, Scans und Fotos in wenigen Sekunden und erkennt Duplikate automatisch, während ein vollständiger GDPR-Audit-Trail jeden Verarbeitungsschritt dokumentiert und eine sichere Anonymisierung sensibler Daten erlaubt.

Für HR-Teams und Personalvermittlungen, die semantisches Matching praktisch einsetzen wollen, zeigen wir die konkrete Umsetzung gern direkt am System. Details zu unseren Plänen, darunter HR Team und Recruitment Agencies, finden Sie auf unserer Preisseite.
FAQ
Was heißt semantisch einfach erklärt?
Semantisch bezieht sich auf die Bedeutung von Wörtern, Sätzen oder Konzepten, nicht auf ihre bloße Schreibweise. Zwei Begriffe können semantisch verwandt sein, obwohl sie sich sprachlich stark unterscheiden, etwa „Kita“ und „Kindertagesstätte“.
Was sind semantische Beziehungen?
Semantische Beziehungen beschreiben, wie Konzepte inhaltlich miteinander verbunden sind, etwa durch Synonymie, Über- und Unterordnung oder thematische Nähe. In Knowledge Graphs werden solche Beziehungen explizit als Kanten zwischen Knoten modelliert, was sie nachvollziehbar und abfragbar macht.
Was bedeutet Matching?
Matching bezeichnet den Prozess, zwei Objekte, etwa einen Lebenslauf und eine Stellenanzeige, einander zuzuordnen, weil sie in einem relevanten Merkmal übereinstimmen oder zusammenpassen. Bei semantischem Matching erfolgt diese Zuordnung über Bedeutungsnähe statt über exakte Wortgleichheit.
Was bedeutet semantisches Modell?
Ein semantisches Modell ist ein Verfahren oder eine Datenstruktur, das Bedeutung maschinenlesbar abbildet, etwa durch Vektor-Embeddings oder Knowledge Graphs. Solche Modelle erlauben es Systemen, Ähnlichkeit und Verwandtschaft zwischen Texten oder Konzepten zu berechnen statt nur Zeichenketten zu vergleichen.
Quellen
Towards Explainable Job Title Matching: Leveraging Semantic Textual Relatedness and Knowledge Graphs
JobMatchAI - production-ready hybrid retrieval and explainable reranking
Empfehlungen
Updates und News
Bleib immer up to date mit den neuesten Innovationen, Features und Tipps rund um Recruitify!
Indem Du Deine E-Mail-Adresse im Anmeldeformular für den Newsletter einträgst, willigst Du in deren Verarbeitung zum Zwecke des Versands von Marketinginformationen über die Produkte und Dienstleistungen des Administrators ein. Der Administrator Deiner zu diesem Zweck verarbeiteten personenbezogenen Daten ist Recruitify Sp. z o.o. mit Sitz in Warschau (KRS 0000709889). Weitere Informationen über die Grundsätze der Verarbeitung personenbezogener Daten und die Rechte der betroffenen Personen findest Du im Dokument Datenschutzerklärung.

Aktualisiert am:
Semantisches Matching: Hybride Methoden und Bewertung für Job-Matching
Neuigkeiten
Recruitify Team
Semantisches Matching ordnet zwei Texte oder Konzepte nach Bedeutung und verbindet damit zum Beispiel Lebensläufe und Stellenanzeigen auch ohne gemeinsame Schlüsselwörter. Technisch stützt sich dieser Ansatz auf drei Bausteine: dichte Embeddings, Knowledge Graphs und hybride Architekturen, die beides kombinieren. Für die Praxis bedeutet das: Kandidatenprofile und Anforderungen lassen sich verknüpfen, selbst wenn Formulierungen stark voneinander abweichen.
Kurz gesagt:
Eine hybride Suche verbindet dichte Einbettungen, BM25 und Wissensgraphen: Sie findet Synonyme, erfasst seltene Fachbegriffe und zeigt nachvollziehbare Verbindungspfade zwischen den Konzepten.
Ein globaler Durchschnitt kann Schwächen bei mehrdeutigen Treffern verdecken; bewerten Sie deshalb Fälle nach geringer, mittlerer und hoher Bedeutungsnähe und berichten Sie Konfidenzintervalle je Gruppe.
Die Ergänzung feinabgestimmter Einbettungsmodelle durch Wissensgraphen senkte in einer Forschungsarbeit den RMSE bei eng verwandten Rollen und Fähigkeiten um rund 25 Prozent.
Bei großen Datenbeständen sollte die Suche zunächst mit Indizes zur näherungsweisen Nachbarsuche und BM25 Kandidaten sammeln; ein teures Sprachmodell bewertet anschließend nur die engere Auswahl.
Für die Personalauswahl in Europa empfiehlt sich, die Inferenz in der EU auszuführen oder Einbettungen lokal zu erzeugen, um Datenverarbeitung und Export einfacher zu regeln.
RecruitifyPassende Talente semantisch erkennenRecruitifys Contextual Matching AI bewertet Kandidatenprofile anhand von Projektanforderungen und erstellt Shortlists mit prozentualem Match-Score.Recruitify entdecken
Inhaltsverzeichnis
Definition und Abgrenzung zu STS und STR
Kernmethoden: Embeddings, Knowledge Graphs und Hybrid-Modelle
Bewertung und Metriken: warum stratifizierte Evaluation sinnvoll ist
Architektur-Pattern für Produktion: retrieve-then-rerank und Skalierung
Anwendungsbeispiel: Job- und Kandidatenmatching
Evidenz und Praxisbelege für erklärbares Matching
Ausblick: Forschungstrends und Prioritäten für Praktiker
Recruitify als DSGVO-gestützte Umsetzung semantischen Matchings
FAQ
Quellen
Definition und Abgrenzung zu STS und STR
Semantisches Matching bezeichnet, formal betrachtet, die Zuordnung zweier Objekte anhand ihres Bedeutungsgehalts statt anhand wörtlicher Übereinstimmung. Das National Institute of Standards and Technology definiert den Begriff als Nutzung kontextueller Attribute zur Interpretation digitaler Objekte, wobei semantische Verfahren tendenziell spezifischere, aber auch rechenintensivere Ergebnisse liefern als rein lexikalische Methoden.
Von zwei verwandten Konzepten muss man semantisches Matching klar abgrenzen:
Semantic Textual Similarity (STS): misst, wie ähnlich zwei Texte in Bedeutung und Formulierung sind.
Semantic Textual Relatedness (STR): erfasst einen breiteren Bezug zwischen Texten, auch wenn sie inhaltlich verschieden, aber thematisch verbunden sind.
Für das Matching von Jobtiteln etwa reicht reine Ähnlichkeit oft nicht aus: Ein „Senior Backend Engineer“ und ein „Lead Platform Developer“ sind sich textuell kaum ähnlich, stehen aber in enger Beziehung. Typische Inputs sind einzelne Sätze, Stellentitel oder Knoten in einem Graphen, je nachdem, welche Granularität die Anwendung verlangt.
Kernmethoden: Embeddings, Knowledge Graphs und Hybrid-Modelle
Dichte Embeddings bilden Wörter, Sätze oder ganze Dokumente als Vektoren in einem hochdimensionalen Raum ab. Modelle wie Sentence-BERT (SBERT) sind speziell darauf trainiert, semantisch ähnliche Sätze nah beieinander zu platzieren, sodass sich Nähe über Kosinus-Ähnlichkeit berechnen lässt. Anders als klassische Keyword-Suche erfasst dieser Ansatz auch Synonyme, Umschreibungen und implizite Zusammenhänge.
Knowledge Graphs ergänzen diese Vektorräume um explizite, strukturierte Relationen: Ein Skill wie „Kubernetes“ lässt sich dort formal mit „Container-Orchestrierung“ oder „DevOps“ verknüpfen. Dadurch entsteht Nachvollziehbarkeit, die reine Embedding-Scores nicht liefern: Man sieht, über welchen Pfad zwei Konzepte verbunden sind.
Hybrid-Designs kombinieren beide Welten mit einer dritten Komponente, der lexikalischen Suche über BM25. Ein typisches Setup sieht so aus:
Ein Embedding-Index liefert semantische Kandidaten jenseits exakter Wortübereinstimmung.
BM25 fängt exakte Begriffe und seltene Fachtermini zuverlässig ab.
Graph-Traversal liefert erklärbare, strukturierte Zusatzrelationen.
Fine-Tuning auf domänenspezifischen Daten verbessert die Trennschärfe solcher Modelle erheblich, oft über Contrastive Learning, bei dem das Modell lernt, ähnliche Paare näher und unähnliche Paare weiter auseinander zu platzieren.
Profi-Tipp: Trainieren Sie Embedding-Modelle mit domänenspezifischen Negativbeispielen, nicht nur mit zufälligen Paaren, denn das schärft die Trennung zwischen echten und oberflächlichen Ähnlichkeiten deutlich.
Bewertung und Metriken: warum stratifizierte Evaluation sinnvoll ist
Precision, Recall und F1-Score bilden die Basismetriken, mit denen sich Matching-Qualität grundsätzlich beurteilen lässt: Precision zeigt, wie viele gefundene Treffer tatsächlich relevant sind, Recall erfasst, wie viele der relevanten Treffer überhaupt gefunden wurden, und F1 verbindet beide zu einem Gesamtwert.
Ein globaler Durchschnittswert verschleiert jedoch oft entscheidende Schwächen. Ein Modell kann bei eindeutigen Fällen glänzen und bei schwierigen, mehrdeutigen Paaren deutlich schlechter abschneiden, ohne dass der Gesamtscore das zeigt. Genau deshalb empfiehlt sich eine stratifizierte Evaluation, die Testfälle nach dem Grad ihrer semantischen Beziehung aufteilt:
Fälle mit niedriger STR: kaum thematischer Bezug.
Fälle mit mittlerer STR: loser, aber erkennbarer Zusammenhang.
Fälle mit hoher STR: enge inhaltliche Nähe.
Die Integration von Knowledge Graphs in feingetunte SBERT-Modelle hat in Forschungsarbeiten zu erklärbarem Job-Titel-Matching den RMSE im hochrelevanten STR-Bereich um rund 25 Prozent reduziert. Diese Verbesserung zeigt sich gerade dort, wo Recruiting-Systeme am meisten auf Präzision angewiesen sind, nämlich bei eng verwandten Rollen und Skills. Für belastbares Reporting lohnt es sich, Konfidenzintervalle je Stratum auszuweisen statt nur einen einzigen Gesamtwert.
Architektur-Pattern für Produktion: retrieve-then-rerank und Skalierung
Für produktive Matching-Systeme hat sich ein zweistufiges Muster durchgesetzt, bekannt als retrieve-then-rerank. Der Ablauf gliedert sich typischerweise so:
Eine schnelle Retrieval-Phase holt mit Approximate-Nearest-Neighbor-Indizes (ANN) und BM25 eine breite Kandidatenmenge aus Millionen von Datensätzen.
Eine Graph-Abfrage reichert diese Kandidaten um strukturierte Relationen an, etwa Skill-Hierarchien oder Karrierepfade.
Ein Reranker, oft ein feingetuntes Transformer-Modell, bewertet die engere Kandidatenmenge präzise neu und liefert die finale Rangfolge.
Kosten spielen bei der Modellwahl eine erhebliche Rolle. Vergleichende Untersuchungen zeigen, dass Embedding-Pipelines für Similarity- und Klassifikationsaufgaben kosteneffizient bleiben, während große Sprachmodelle deutlich teurer ausfallen und sich vor allem für reasoning-intensive Retrieval-Schritte lohnen. Ein sinnvolles Muster trennt deshalb die Aufgaben: Embeddings übernehmen den schnellen, breiten Filter, ein LLM bewertet nur die verbleibende Shortlist.
Für Nachvollziehbarkeit kombiniert man deterministische Ähnlichkeits-Scores mit graphbasierten Pfaden, die zeigen, warum zwei Entitäten als verwandt gelten. Bei wachsendem Datenvolumen helfen approximative Indexstrukturen und Caching häufiger Anfragen, die Antwortzeiten stabil zu halten.
Anwendungsbeispiel: Job- und Kandidatenmatching
Jobtitel sind ein klassisches Beispiel für die Schwächen reiner Schlagwortsuche: „Data Engineer“, „Dateningenieur“ und „Analytics Engineer“ bezeichnen oft ähnliche, aber nicht identische Rollen, und eine einfache Keyword-Suche übersieht solche Übergänge regelmäßig.
Eine End-to-End-Pipeline für Kandidatenmatching durchläuft typischerweise folgende Schritte:
Ingestion: Lebensläufe und Stellenanzeigen werden strukturiert aufbereitet.
Embedding: Skills, Titel und Erfahrungen werden in Vektoren umgewandelt.
Graph-Anreicherung: Skill-Beziehungen und Karrierepfade ergänzen die Vektordaten.
Reranking: Eine finale Bewertung liefert eine erklärbare Rangfolge.
Demo-Deployments mit produktionsreifen Hybrid-Retrieval-Stacks zeigen, dass die Kombination aus BM25, dichten Embeddings und Graph-Traversal bessere Ranking-Ergebnisse liefert als rein lexikalische Ansätze, und gleichzeitig auditierbare Erklärungen ermöglicht. Für DSGVO-relevante Architekturentscheidungen empfiehlt sich dabei, Inferenz EU-seitig zu hosten oder Embeddings lokal zu erzeugen, wie unser Beitrag zu Compliance beim Einsatz von KI im Recruiting näher beschreibt.
Evidenz und Praxisbelege für erklärbares Matching
Mehrere Forschungsarbeiten stützen die hier beschriebenen Architekturentscheidungen mit konkreten Ergebnissen statt mit allgemeinen Behauptungen.
Die KG-Integration in feingetunte Embedding-Modelle verbessert messbar die Erklärbarkeit von Matches, weil getrennte Graphpfade nachvollziehbar bleiben.
Stratifizierte Evaluation deckt Modellschwächen auf, die globale Metriken verbergen, und erlaubt gezielte Modellwahl für High-STR-Anwendungsfälle wie HR.
Für europäische Kontexte empfehlen Praxisleitfäden zu DSGVO-konformer KI lokale Embeddings oder EU-gehostete Inferenzendpunkte, um Fragen zu Auftragsverarbeitung und Datenexport zu vereinfachen.
Die Integration von Knowledge Graphs reduzierte den RMSE im High-STR-Bereich in kontrollierten Experimenten um etwa ein Viertel, ein Hinweis darauf, dass strukturierte Relationen gerade bei eng verwandten Profilen einen messbaren Unterschied machen. Eine Contextual Matching AI bewertet Tech-Stacks im Kontext, nicht als isolierte Schlagwortliste, und ein AI CV Parser extrahiert strukturierte Profile aus verschiedensten Dateiformaten, während ein vollständiger GDPR-Audit-Trail jeden Verarbeitungsschritt dokumentiert.
Ausblick: Forschungstrends und Prioritäten für Praktiker
Die Integration von Knowledge Graphs in Embedding-basierte Systeme wird aus unserer Sicht weiter zunehmen, einfach weil Erklärbarkeit in regulierten Bereichen wie HR kein Nebenaspekt mehr ist, sondern eine Voraussetzung. Retrieve-then-rerank bleibt dabei das dominante Produktionsmuster, LLMs kommen gezielt dort zum Einsatz, wo reines Reasoning gefragt ist, nicht als Ersatz für effiziente Embedding-Pipelines. Wer jetzt plant, sollte auf modulare, auditierbare Architekturen setzen statt auf monolithische Blackboxes.
- Recruitify Team
Recruitify als DSGVO-gestützte Umsetzung semantischen Matchings
Die hier beschriebenen Prinzipien, hybride Retrieval-Architekturen, stratifizierte Bewertung und erklärbare Scores, lassen sich mit einer passenden Plattform direkt umsetzen, ohne dass Ihr Team ein eigenes Matching-System aufbauen muss. Eine Contextual Matching AI bewertet Tech-Stacks und Erfahrungen kontextuell und liefert fertige Shortlists mit einem prozentualen Match-Score statt einer bloßen Keyword-Trefferliste. Ein AI CV Parser extrahiert strukturierte Profile aus PDFs, DOCX-Dateien, Scans und Fotos in wenigen Sekunden und erkennt Duplikate automatisch, während ein vollständiger GDPR-Audit-Trail jeden Verarbeitungsschritt dokumentiert und eine sichere Anonymisierung sensibler Daten erlaubt.
Für HR-Teams und Personalvermittlungen, die semantisches Matching praktisch einsetzen wollen, zeigen wir die konkrete Umsetzung gern direkt am System. Details zu unseren Plänen, darunter HR Team und Recruitment Agencies, finden Sie auf unserer Preisseite.
FAQ
Was heißt semantisch einfach erklärt?
Semantisch bezieht sich auf die Bedeutung von Wörtern, Sätzen oder Konzepten, nicht auf ihre bloße Schreibweise. Zwei Begriffe können semantisch verwandt sein, obwohl sie sich sprachlich stark unterscheiden, etwa „Kita“ und „Kindertagesstätte“.
Was sind semantische Beziehungen?
Semantische Beziehungen beschreiben, wie Konzepte inhaltlich miteinander verbunden sind, etwa durch Synonymie, Über- und Unterordnung oder thematische Nähe. In Knowledge Graphs werden solche Beziehungen explizit als Kanten zwischen Knoten modelliert, was sie nachvollziehbar und abfragbar macht.
Was bedeutet Matching?
Matching bezeichnet den Prozess, zwei Objekte, etwa einen Lebenslauf und eine Stellenanzeige, einander zuzuordnen, weil sie in einem relevanten Merkmal übereinstimmen oder zusammenpassen. Bei semantischem Matching erfolgt diese Zuordnung über Bedeutungsnähe statt über exakte Wortgleichheit.
Was bedeutet semantisches Modell?
Ein semantisches Modell ist ein Verfahren oder eine Datenstruktur, das Bedeutung maschinenlesbar abbildet, etwa durch Vektor-Embeddings oder Knowledge Graphs. Solche Modelle erlauben es Systemen, Ähnlichkeit und Verwandtschaft zwischen Texten oder Konzepten zu berechnen statt nur Zeichenketten zu vergleichen.
Quellen
Towards Explainable Job Title Matching: Leveraging Semantic Textual Relatedness and Knowledge Graphs
JobMatchAI - production-ready hybrid retrieval and explainable reranking
Empfehlungen
Updates und News
Bleib immer up to date mit den neuesten Innovationen, Features und Tipps rund um Recruitify!
Indem Du Deine E-Mail-Adresse im Anmeldeformular für den Newsletter einträgst, willigst Du in deren Verarbeitung zum Zwecke des Versands von Marketinginformationen über die Produkte und Dienstleistungen des Administrators ein. Der Administrator Deiner zu diesem Zweck verarbeiteten personenbezogenen Daten ist Recruitify Sp. z o.o. mit Sitz in Warschau (KRS 0000709889). Weitere Informationen über die Grundsätze der Verarbeitung personenbezogener Daten und die Rechte der betroffenen Personen findest Du im Dokument Datenschutzerklärung.
Schau dir auch das an
Dein Rekrutierungsprozess
Recruiting Operations: Rolle, Aufgaben und Anforderungen im Überblick
Recruiting Operations schafft stabile Prozesse, saubere Bewerberdaten und datenschutzkonforme Abläufe, damit HR Teams schneller rechtssicher einstellen.
10.10.2026
Mehr erfahren
Dein Rekrutierungsprozess
Privacy by Design in HR: Pflichten und konkrete Maßnahmen
Datenschutz durch Technikgestaltung macht Personalprozesse nach Art. 25 DSGVO rechtssicher; Pflichten und umsetzbare Maßnahmen für Daten und Systeme.
08.10.2026
Mehr erfahren
Dein Rekrutierungsprozess
Staff Augmentation erklärt: Modelle, Recht und Praxis für IT-Teams
Der Beitrag erklärt, wie befristete Personalaufstockung durch externe IT-Fachkräfte Skill-Lücken schließt, Fristdruck reduziert und Projekte schneller...
07.10.2026
Mehr erfahren
Dein Rekrutierungsprozess
Recruiting Operations: Rolle, Aufgaben und Anforderungen im Überblick
Recruiting Operations schafft stabile Prozesse, saubere Bewerberdaten und datenschutzkonforme Abläufe, damit HR Teams schneller rechtssicher einstellen.
10.10.2026
Mehr erfahren
Dein Rekrutierungsprozess
Privacy by Design in HR: Pflichten und konkrete Maßnahmen
Datenschutz durch Technikgestaltung macht Personalprozesse nach Art. 25 DSGVO rechtssicher; Pflichten und umsetzbare Maßnahmen für Daten und Systeme.
08.10.2026
Mehr erfahren